AI 가속기의 다음 병목: HBM 스택과 첨단 패키징 총정리
HBM 스택 제작과 GPU-HBM 통합 패키징이 어떻게 다른지 설명하고, CoWoS와 TC본더, 유리기판, 초박형 칩 적층 연구까지 패키징 병목을 둘러싼 기술과 공급망을 하나로 정리합니다.

이 글은 AI 인프라와 반도체 구조를 이해하기 위한 QSike Tech Notes 기술 해설입니다. 특정 기업이나 제품의 성능을 보증하지 않으며, 실제 제품 구조는 세대와 고객 요구에 따라 달라질 수 있습니다.
AI 서버를 설명할 때 가장 자주 등장하는 단어는 GPU와 HBM이다. GPU는 대규모 행렬 연산을 담당하고, HBM은 그 연산에 필요한 데이터를 빠르게 공급한다. 하지만 실제 AI 가속기는 GPU와 HBM을 각각 잘 만드는 것만으로 완성되지 않는다. 둘을 매우 가까운 거리에서, 매우 넓은 통로로, 안정적으로 연결해야 한다.
이 연결 과정이 바로 첨단 패키징의 영역이다. AI 가속기의 병목을 이해하려면 “HBM을 누가 만들었나”와 “GPU와 HBM을 하나의 패키지로 어떻게 묶었나”를 나누어 봐야 한다.
참고: 이 글은 2026년 6~8월에 각각 발행된 패키징 관련 글 네 편(HBM 스택과 통합 패키징, HBM4와 CoWoS·TC본더, 유리기판과 인터포저, POSTECH 초박형 칩 적층)을 하나의 가이드로 재구성했습니다.
HBM 스택 제작과 GPU-HBM 통합은 다른 단계다
HBM은 여러 장의 D램 다이를 수직으로 쌓고, TSV라는 수직 연결 통로를 통해 위아래 칩을 연결한 메모리다. 이 단계에서는 얇은 칩을 안정적으로 쌓는 기술, 열과 압력을 제어하는 접합 기술, 수율을 확보하는 검사 기술이 중요하다.
하지만 HBM 스택이 완성됐다고 곧바로 AI 가속기가 되는 것은 아니다. 완성된 HBM 스택은 GPU나 AI 가속기 로직 다이 옆에 배치되고, 인터포저나 고성능 기판을 통해 아주 넓은 데이터 통로로 연결된다. 이 두 번째 단계가 GPU-HBM 통합 패키징이다.

따라서 “HBM 패키징”이라는 표현은 문맥에 따라 두 가지를 뜻할 수 있다.
- HBM 자체를 쌓고 접합하는 메모리 후공정
- GPU와 HBM을 한 패키지 안에서 연결하는 2.5D 통합 패키징
이 둘은 연결되어 있지만 같은 일이 아니다. HBM 스택이 충분해도 통합 패키징 용량이 부족하면 AI 가속기 출하가 막힐 수 있고, 반대로 통합 패키징 라인이 있어도 인증된 HBM 스택이 부족하면 전체 공급이 늘지 않는다.
HBM4는 메모리 제품이면서 패키징 제품이다
HBM4 뉴스가 나오면 헤드라인을 차지하는 숫자는 대역폭과 I/O다. 삼성전자는 HBM4가 최대 3,300GB/s 대역폭과 2,048개 I/O 핀을 제공한다고 설명하고, SK하이닉스도 HBM4를 2K I/O 기반의 차세대 AI 메모리로 제시한다. 하지만 HBM4를 “더 빠른 D램”으로만 보면 공급망의 핵심을 놓친다.
HBM4의 성능 향상은 칩 내부 스펙만으로 끝나지 않는다. 삼성전자는 최선단 1c 나노급 D램, 파운드리 4nm 로직 베이스 다이, 메모리·파운드리·선단 패키징 역량을 함께 강조한다. SK하이닉스도 로직 파운드리 공정 기반 베이스 다이와 고단 적층 패키징을 함께 언급한다. D램 웨이퍼가 충분해도 본딩 장비가 부족하면 적층 속도가 제한되고, 본딩이 충분해도 CoWoS 같은 패키징 캐파가 부족하면 AI 가속기에 실장되는 최종 패키지가 늦어진다.
| 단계 | 내용 | 병목이 생기기 쉬운 요인 |
|---|---|---|
| 1. 코어 다이 제조 | 선단 D램 공정으로 코어 다이 제작 | 웨이퍼 캐파, 선단 공정 수율 |
| 2. 베이스 다이 제조 | 파운드리 로직 공정으로 베이스 다이 제작 | 파운드리 캐파, 설계 복잡도 |
| 3. TSV·적층 | TSV 형성 후 TC본더로 다이를 정렬·접합 | TC본더 대수, 정렬·열 제어 정밀도, 수율 |
| 4. HBM 패키지 검사 | 적층된 HBM 단품의 전기·신뢰성 검증 | 검사 시간, 양품 판정 비율 |
| 5. 첨단 패키징 | 인터포저 위에서 GPU·ASIC과 HBM 통합 | 패키징 캐파, 인터포저 크기·수율 |
| 6. 고객 인증 | 가속기 패키지 검증 후 고객 품질 조건 통과 | 인증 기간, 신뢰성 요구 조건 |
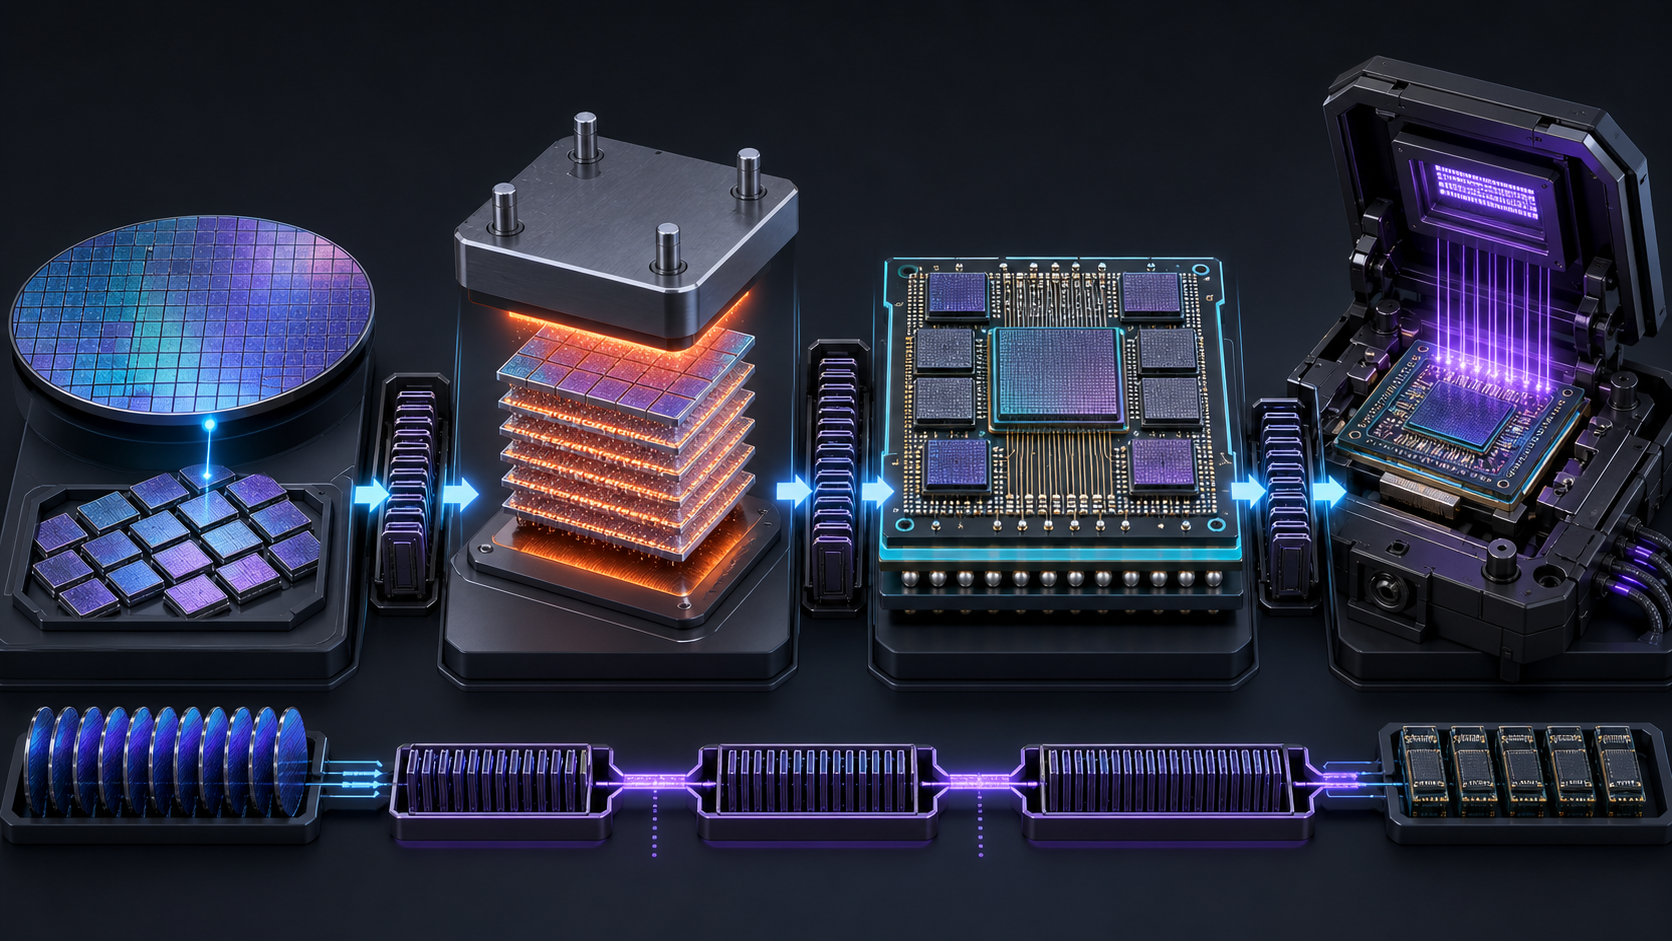 한 단계의 지연도 최종 AI 가속기 출하를 늦출 수 있다.
장비가 들어와도 공정 조건을 잡고 고객 인증을 통과하기 전까지는 안정 공급으로 보기 어렵다. 특히 적층 본딩과 첨단 패키징은 캐파를 단기간에 늘리기 어렵고 장비 조달 리드타임이 길다.
왜 인터포저와 기판이 중요해졌나
AI 가속기에서는 GPU와 HBM 사이에 오가는 데이터 양이 매우 크다. 그래서 둘을 일반 회로기판 위에 멀리 떨어뜨려 연결하면 충분한 대역폭과 전력 효율을 얻기 어렵다. 대신 GPU와 HBM을 가까이 놓고, 인터포저나 고성능 패키지 기판 위에서 촘촘한 배선으로 연결한다.
여기서 인터포저와 기판을 나눠 볼 필요가 있다. 반도체 패키지는 칩이 놓이는 바닥부터 메인보드까지 여러 층으로 구성된다.
- 인터포저(Interposer): 칩과 기판 사이의 초미세 다리다. 칩의 아주 촘촘한 배선을 기판이 이해할 수 있는 간격으로 넓혀주는 중간 층이며, 현재는 실리콘 인터포저가 주류다.
- 기판(Substrate): 패키지 전체를 지지하고 메인보드(PCB)와 연결하는 최종 바닥판이다. 지금까지는 플라스틱 계열의 유기물 기판이 쓰였다.
CoWoS는 이런 GPU-HBM 통합 패키징을 설명할 때 자주 언급되는 대표적인 2.5D 방식이다. TSMC가 2012년부터 양산해 온 웨이퍼 레벨 시스템 통합 기술로, 큰 실리콘 인터포저 위에 로직 다이를 올리고 HBM 큐브를 적층한다. CoWoS-S는 최대 3.3X 리티클 인터포저를 지원하고, 더 큰 인터포저는 RDL 기반(-R) 또는 결합형(-L) 변형으로 대응한다. CoWoS 캐파는 고정된 단일 기술의 문제가 아니라 계속 확장 중인 기술 제품군의 문제다. FOPLP는 더 큰 패널 단위에서 패키지를 만들며 비용과 생산성을 개선하려는 접근으로 자주 거론된다.
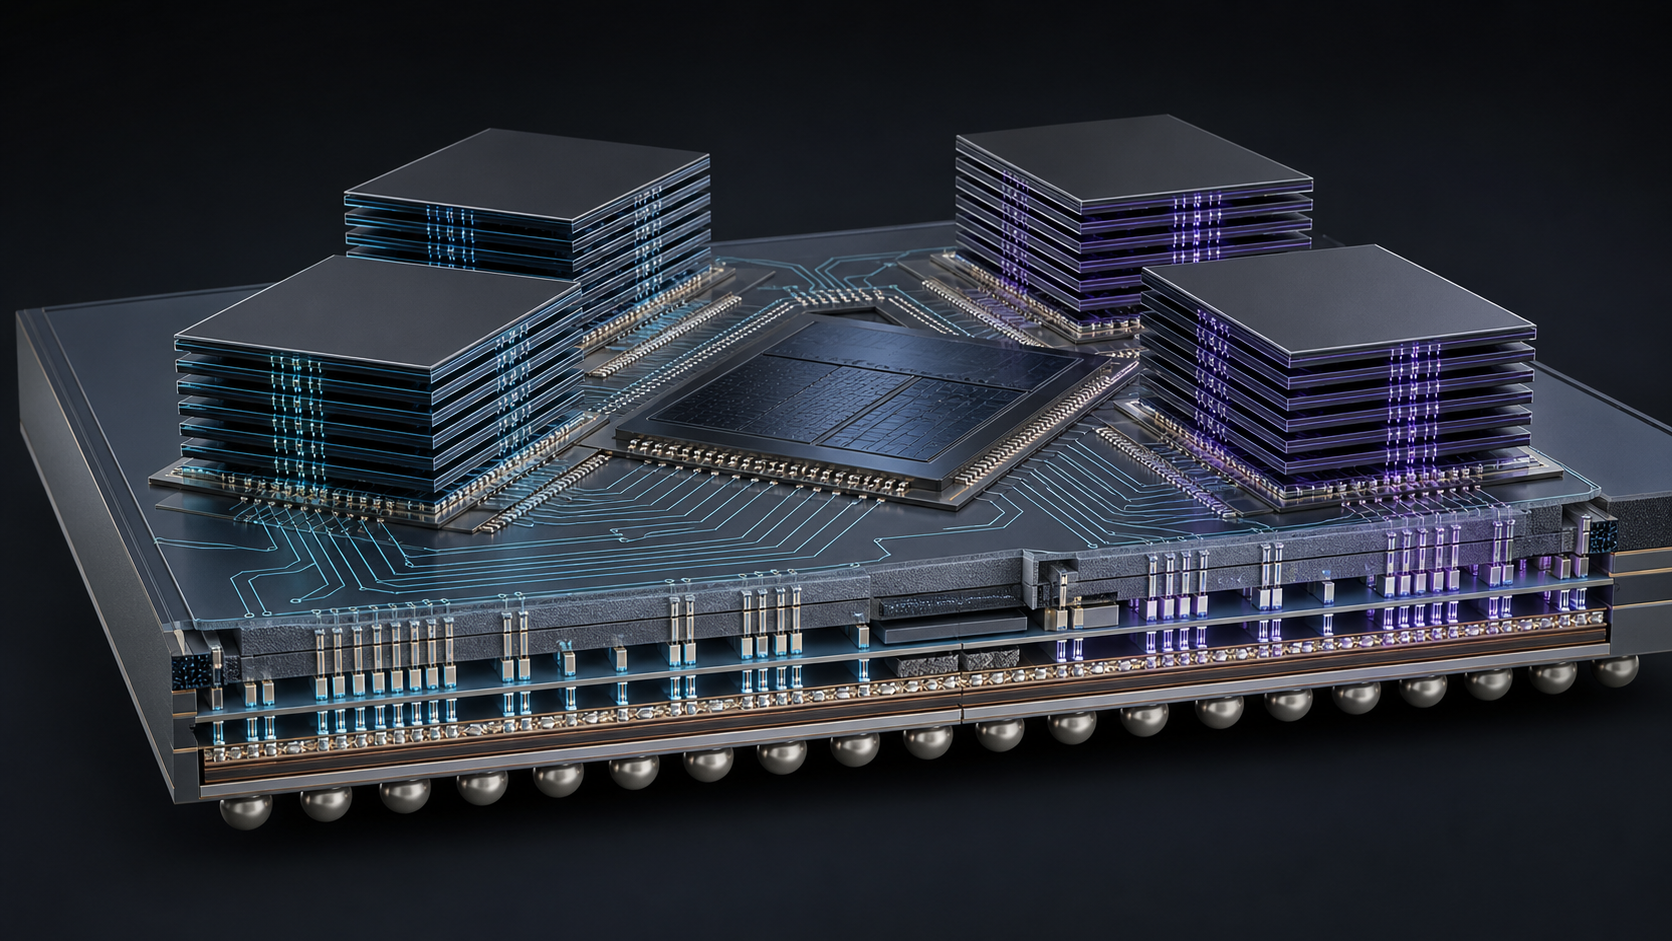 첨단 패키징은 HBM 단품을 고객이 쓰는 AI 가속기 패키지로 바꾸는 관문이다.
이 구조는 성능에는 유리하지만 제조 난이도를 높인다. 패키지가 커질수록 배선 밀도, 기판 평탄도, 열 팽창 차이, 검사 난이도, 수율 관리가 모두 까다로워진다. AI 서버 수요가 늘어날 때 단순히 GPU 칩 생산만 늘려서는 부족한 이유가 여기에 있다.
TC본더는 ‘쌓는 속도’와 ‘쌓은 뒤 수율’을 동시에 건드린다
TC본더는 열압착 방식으로 D램 다이를 쌓아 붙이는 장비다. HBM4에서 본딩 정밀도와 열 제어 안정성이 더 중요해지고, TSV 공정을 거친 다이를 정렬해 열과 압력으로 접합하며, 적층 수가 늘수록 장비 성능과 세팅 노하우가 수율에 직결된다.
TC본더는 단순히 장비 한 대를 더 사는 문제만은 아니다. 장비 속도가 느리면 생산량이 제한되고, 정밀도가 부족하면 수율이 낮아진다. 수율이 낮으면 같은 웨이퍼와 장비를 써도 실제 출하 가능한 제품은 줄어든다. 가령 HBM4 다이 12단을 적층하는 라인을 준비한다면, 목표 양산 시점보다 앞서 TC본더를 발주하고 장비 반입 뒤에도 정렬·열 공정 조건을 조정해 수율을 끌어올릴 시간이 필요하다.
장비 공급망 다변화 움직임도 같은 맥락에서 읽을 수 있다. 삼성전자가 ASMPT와 HBM용 TC본더 데모 테스트를 마치고 공동평가프로젝트를 추진한다는 보도가 있었고, 한미반도체와 SK하이닉스의 HBM4용 TC본더 공급계약, HBM4 전용 TC본더 4의 생산·공급 계획도 국내 언론을 통해 보도됐다. 장비 공급사를 추가하거나 공정 조건을 분산하는 선택은 비용보다 양산 리스크를 나누는 운영 결정이 될 수 있다.
표준 경쟁도 본딩 방식 자체를 바꾸는 방향으로 이어진다. JEDEC은 2025년 4월 HBM4 표준 JESD270-4를 발표했다. 문서 표준은 메모리 인터페이스를 정의하지만, 메모리를 어떤 방식으로 쌓고 가속기와 어떤 패키지로 통합할지는 양산 라인에서의 선택이 정한다. 더 높은 적층, 더 미세한 피치, 더 나은 열·전기적 특성이 요구될수록 하이브리드 본딩에 대한 관심이 커진다. TSMC의 SoIC 플랫폼은 10µm 미만 본딩 피치에서 시작하는 3D 적층 기술이며 SoIC-X는 웨이퍼-웨이퍼 본딩 기반이다. 다만 장비가 존재한다는 것과 HBM 양산 라인의 전환 시점이 정해졌다는 것은 다른 이야기다.
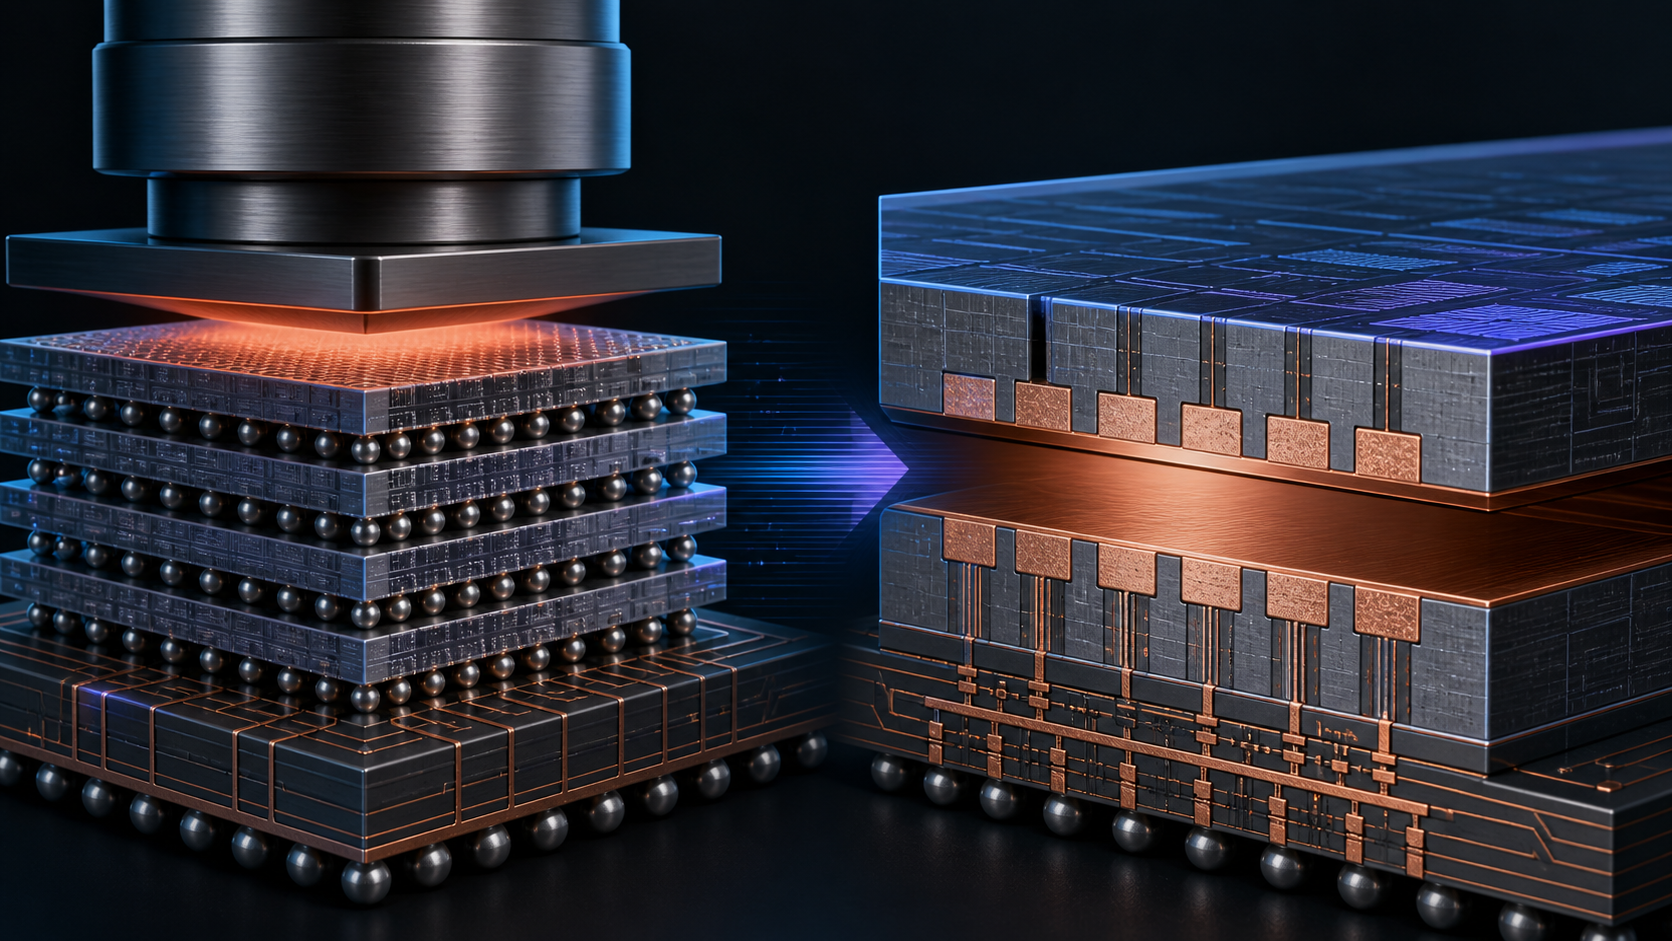 본딩 방식의 변화는 장비 확보만이 아니라 수율·검증·생태계의 전환 문제다.
유리기판: 소재의 세대 교체 시도
패키징 경쟁은 접합 장비에서 소재로도 확장된다. 최근 업계의 화두인 유리기판을 이해하려면 무엇을 바꾸려 하는지 계층부터 명확히 해야 한다. 유리는 인터포저와 기판 두 계층 모두에서 기존 소재를 대체할 수 있는 후보다. 실리콘 인터포저를 유리 인터포저로, 유기물 기판을 유리기판으로 바꾸려는 시도가 동시에 일어나고 있다.
왜 굳이 유리를 쓰려는 걸까. AI 반도체가 거대해지면서 기존 실리콘과 유기물의 물리적 한계가 임계점에 도달했기 때문이다.

- 전기적 특성: 실리콘은 반도체 성질을 띠어 고주파 신호가 흐를 때 기생 손실이 발생한다. 유리는 완벽한 절연체라 고주파에서도 신호 손실이 극히 적어 전력 효율에 유리하다.
- 가공 면적: 실리콘은 웨이퍼 단위로 생산하므로 크기가 제한적이다. 칩렛을 많이 묶어 패키지가 커지면 리티클 제한에 걸려 여러 장을 이어 붙이는 스티칭 공정이 필요하고 수율과 비용에 부담이 된다. 유리는 디스플레이처럼 거대 패널 단위로 생산이 가능하다.
- 열 관리: 실리콘은 열전도율이 높아 방열에 유리하다. 유리는 열전도율이 낮아 열을 가둬두는 성질이 있어, 구리 필러 삽입이나 정교한 액체 냉각 설계 같은 별도 방열 전략이 필수다.
- 안정성: 유리는 표면 평탄도가 높고 열팽창 계수(CTE)를 조절할 수 있어 대형 패키지의 휨(Warpage)을 줄일 수 있다.
유리기판의 핵심 공정은 유리에 미세한 구멍을 뚫고 금속을 채우는 TGV(Through Glass Via)다. 유리는 깨지기 쉬운 취성 소재라 단순히 구멍을 뚫으면 미세한 크랙이 생겨 수율이 급락할 수 있다. 레이저 유도 에칭 같은 고도의 공정 기술과, 매끄러운 유리 표면에 금속 배선이 달라붙게 만드는 접착력 확보가 양산의 관건이다.
인텔, TSMC, 엔비디아 모두 유리를 연구하지만 삼성의 접근은 구현 밸류체인의 수직 통합에 있다. 삼성전기는 동우화인켐과 합작법인 ‘글라셈’을 설립해 약 3,191억 원을 투자하고 지분 66.2%를 확보하며 유리 코어 소재 공급망을 내재화했다. 삼성디스플레이는 대면적 유리 가공과 패터닝 경험을 갖고 있고, 삼성전자는 칩 설계부터 HBM, 파운드리, 첨단 패키징까지 수행하는 최종 수요처다. 소재에서 가공, 적용으로 이어지는 피드백 루프가 그룹 내에 구축되면 경쟁사보다 빠르게 수율을 잡을 가능성이 생긴다.
경쟁 구도도 다르다. TSMC는 이미 CoWoS라는 실리콘 인터포저 생태계를 구축했으므로 유리를 도입하더라도 기존 생태계를 유지하며 점진적으로 보완하는 수성 전략에 가깝고, SK하이닉스는 HBM-로직-인터포저를 하나로 묶는 통합 패키징에 집중한다. 삼성은 유리라는 소재의 세대 교체를 통해 기존 실리콘 중심의 패키징 장벽을 넘으려는 공격적 전환 전략을 택하고 있다. 승부는 “누가 유리를 썼는가”가 아니라 “누가 가장 빠르게 수율을 잡고 실제 서버에 태우는가”에서 갈린다.
연구 전선: 같은 높이에 더 쌓는 초박형 칩 적층
패키징 경쟁의 방향을 보여주는 연구 사례도 있다. POSTECH 기계공학과 김석 교수 연구팀은 머리카락 두께의 5분의 1 수준인 약 14μm 초박형 실리콘 칩을 10층 이상 안정적으로 쌓는 기술을 발표했다. 기존 12-Hi(12단) HBM 대비 같은 패키지 높이에서 약 4배 더 많은 칩을 쌓을 수 있는 집적 밀도를 달성했다는 설명이며, 연구는 국제 학술지 Results in Engineering에 게재됐다.
여기서 중요한 건 “4배”가 의미하는 바다. 연구진이 비교한 지표는 같은 패키지 높이 안에 쌓을 수 있는 층 수, 즉 적층 집적도다. 12단 HBM보다 메모리 용량이 네 배라는 뜻도, 대역폭·연산 성능·전력 효율이 네 배라는 뜻도 아니다. 완성된 HBM 제품에는 메모리 다이 외에도 로직 베이스 다이, TSV, 외부 인터페이스, 열 관리와 신뢰성 사양이 함께 들어간다. 이번 결과는 완성된 HBM 스택을 제품 조건에서 비교한 시험이 아니라 초박형 칩을 낮은 온도와 압력에서 반복 정렬·접합하는 제조 방법을 보여준 연구다.
연구팀의 접근은 칩을 정확히 옮기는 전사 프린팅(transfer printing)과 옮기는 동시에 금속 배선을 형성하는 인시투 접합(in-situ bonding)을 결합한 것이다. 칩을 옮기고, 붙이고, 전기적으로 연결하는 과정을 하나의 공정 안에서 처리하면 초박형 칩을 다시 잡고 옮길 때 생길 수 있는 정렬 오차와 손상 기회를 줄일 가능성이 있다. 180°C 이하, 20kPa 이하의 비교적 낮은 온도와 압력 조건이라는 점도 기존 층의 손상과 휨 부담을 줄이는 방향이다. 다만 이 장점이 양산 수율로 이어지는지는 별도 검증이 필요하다.

연구 성과와 양산 기술은 다르다. 실제 산업 적용에서는 “10층을 쌓았다”는 결과뿐 아니라 반복 생산했을 때의 특성 유지가 확인되어야 한다.
| 검증 항목 | 확인해야 할 질문 |
|---|---|
| 전기적 연결 | 모든 층에서 접촉 저항과 신호 무결성이 유지되는가 |
| 열 신뢰성 | 반복 가열·냉각 뒤 접합부와 초박형 다이에 균열이 없는가 |
| 정렬·수율 | 웨이퍼 또는 대면적 공정에서 오차 분포와 불량률은 어떤가 |
| 생산성 | 층을 추가할 때 공정 시간과 비용이 감당 가능한가 |
| 열 방출 | 내부층의 열을 패키지 밖으로 전달할 경로가 충분한가 |
| 기존 공정 결합 | TSV·하이브리드 본딩·인터포저와 어떻게 통합되는가 |
패키징 병목은 전력과 열 문제로 이어진다
AI 가속기 패키지는 데이터를 빠르게 옮기는 것만 생각해서는 안 된다. GPU와 HBM은 동시에 많은 전력을 쓰고, 이 과정에서 열이 발생한다. 패키지 안에서 전력이 불안정하면 신호 품질이 흔들리고, 열이 제대로 빠지지 않으면 성능이 낮아지거나 안정성이 떨어질 수 있다.
그래서 첨단 패키징에서는 다음 요소가 함께 중요해진다.
- 인터포저와 고밀도 배선: GPU와 HBM 사이의 넓은 데이터 통로
- 전력 전달망: 고성능 칩에 안정적으로 전력을 공급하는 구조
- 열 경로: 다이, 히트 스프레더, 냉각 장치로 이어지는 열 방출 경로
- 패키지 기판: 큰 패키지를 물리적으로 지탱하고 외부 시스템과 연결하는 기반
- 검사와 수율: 복잡한 패키지에서 결함을 줄이고 양산성을 확보하는 과정

이 병목들은 서로 연결되어 있다. 배선을 촘촘하게 만들면 신호와 전력 설계가 어려워지고, 패키지가 커지면 열과 휨 문제가 커진다. 검사 시간이 길어지면 같은 장비로 처리할 수 있는 물량도 줄어든다. AI 가속기 공급망에서 패키징이 중요한 이유는 바로 이 복합성 때문이다.
HBM 세대가 올라갈수록 패키징 난이도도 올라간다
HBM3E, HBM4, 이후 세대로 갈수록 메모리 대역폭과 용량 요구는 계속 커진다. 더 많은 층을 쌓고, 더 높은 속도로 데이터를 주고받으며, 더 큰 AI 가속기 패키지 안에서 안정적으로 동작해야 한다.
이때 중요한 질문은 단순히 “더 빠른 HBM인가”가 아니다.
- HBM 스택이 고단화되어도 열과 휨을 제어할 수 있는가
- GPU와 HBM 사이의 통합 패키징 용량이 충분한가
- 대형 패키지에서 기판과 인터포저 수율을 유지할 수 있는가
- 전력 전달과 냉각 구조가 실제 서버 환경에서 버틸 수 있는가
- 고객 시스템에서 장기간 안정적으로 검증되는가
AI 서버의 성능은 칩 하나의 사양이 아니라 전체 패키지와 시스템 설계의 결과다. 그래서 HBM 경쟁은 메모리 기술 경쟁이면서 동시에 패키징, 기판, 전력, 냉각, 검사 역량의 경쟁이 된다.
공급망에서 패키징 병목이 생기는 방식
첨단 패키징 병목은 한 장비가 부족해서만 생기지 않는다. 여러 단계가 동시에 맞아야 하므로 작은 지연이 전체 출하 지연으로 커질 수 있다. 먼저 GPU나 AI 가속기 로직 다이가 준비되어야 하고, 고객이 요구하는 HBM 스택도 충분해야 한다. 그다음 인터포저, 기판, 접합 장비, 검사 장비, 열 설계가 한 흐름으로 이어져야 한다.
문제는 각 단계의 증설 속도가 다르다는 점이다. 웨이퍼 생산능력은 늘렸지만 고성능 기판이 부족할 수 있고, HBM은 확보했지만 대형 인터포저 처리량이 부족할 수 있다. 검사 시간이 길어져 병목이 생기기도 한다. AI 가속기는 단가가 높고 구조가 복잡하기 때문에 작은 수율 하락도 공급량과 비용에 큰 영향을 준다.
이런 이유로 AI 반도체 공급망에서는 “칩 생산량”보다 “완성 패키지 출하량”이 더 현실적인 지표가 된다. 발표된 GPU 수요가 커도, 실제 데이터센터에 설치되는 서버 수는 패키징과 기판, 냉각, 전력 설계가 따라오는 속도에 맞춰 결정된다.
서버와 데이터센터까지 이어지는 검증
패키징은 반도체 공정 안에서 끝나는 문제가 아니다. AI 가속기 패키지가 완성된 뒤에는 서버 보드, 전원부, 냉각 모듈, 랙 단위 설계와 맞아야 한다. 고성능 패키지는 전력 밀도가 높고 발열도 크기 때문에, 데이터센터 냉각 방식과도 연결된다.
예를 들어 같은 GPU와 HBM 조합이라도 서버 제조사와 클라우드 사업자가 요구하는 전력 한계, 랙 배치, 냉각 방식에 따라 실제 동작 조건은 달라질 수 있다. 일부 환경에서는 공랭으로 충분하지 않아 액체 냉각이나 더 복잡한 열 관리가 필요한다. 이 경우 패키징 설계는 데이터센터 운영 방식과 분리해서 볼 수 없다.
그래서 첨단 패키징 경쟁은 반도체 회사만의 경쟁이 아니라 장비, 소재, 기판, 서버 제조, 클라우드 운영사가 함께 맞물리는 생태계 경쟁이다. AI 가속기의 다음 병목을 보려면 어느 회사가 어떤 칩을 만들었는지만 볼 것이 아니라, 그 칩이 어떤 패키징 구조로 서버 안에 들어가고 어떤 데이터센터 조건에서 운영되는지까지 따라가야 한다.
독자가 확인하면 좋은 질문
AI 반도체 뉴스를 읽을 때는 다음 질문이 도움이 된다.
| 질문 | 의미 |
|---|---|
| D램 생산은 충분한가 | 메모리 웨이퍼와 선단 공정 확보 문제 |
| 베이스 다이는 어떤 공정으로 가는가 | 로직·파운드리 의존도와 전력 효율 문제 |
| TC본더는 충분히 확보됐는가 | 적층 속도와 초기 수율 안정화 문제 |
| CoWoS 또는 유사 패키징 캐파는 충분한가 | 최종 AI 가속기 패키지 출하량 문제 |
| 하이브리드 본딩 전환은 언제인가 | 다음 세대 공정 표준과 장비 재편 문제 |
| 고객 인증은 통과했는가 | 기술 가능성과 안정 공급의 차이 |
이 질문을 나누어 보면 공급 부족 뉴스도 더 정확하게 읽을 수 있다. 단순히 “HBM이 부족하다”는 말 속에도 메모리 칩 부족, 고객 인증 지연, 패키징 용량 부족, 기판 부족, 서버 냉각 제약이 섞여 있을 수 있기 때문이다.
왜 이 주제가 일반 독자에게도 중요한가
첨단 패키징은 전문적인 반도체 용어처럼 보이지만, 실제로는 AI 서비스 가격과 공급 속도에 영향을 준다. 패키징 용량이 부족하면 고성능 가속기 출하가 늦어지고, 클라우드 사업자는 원하는 만큼 서버를 늘리지 못한다. 그러면 기업 사용자는 더 비싼 인스턴스 가격이나 긴 대기 시간으로 그 영향을 경험할 수 있다.
따라서 AI 반도체 뉴스를 볼 때 패키징을 이해하면 “좋은 칩이 발표됐다”와 “그 칩이 충분히 공급된다” 사이의 차이를 볼 수 있다. 이 차이가 실제 AI 인프라의 확장 속도를 결정한다.
정리: AI 반도체는 칩이 아니라 패키지 단위로 봐야 한다
AI 가속기를 이해할 때 GPU, HBM, 패키징을 따로 떼어 보면 구조가 단순해 보인다. 하지만 실제 병목은 이 세 가지가 만나는 지점에서 생긴다.
HBM은 데이터를 빠르게 공급하는 메모리이고, GPU는 그 데이터를 계산하는 장치다. 첨단 패키징은 둘을 하나의 고성능 시스템으로 묶는 연결 구조다. 그 연결 구조 안에는 TC본더와 같은 장비, 인터포저와 기판이라는 계층, 유리 같은 차세대 소재, 초박형 적층 같은 연구 전선이 모두 들어 있다.
앞으로 AI 인프라를 볼 때는 “어떤 HBM을 쓰는가”와 함께 “그 HBM이 어떤 패키징 구조로 AI 가속기에 통합되는가”를 같이 봐야 한다. GPU만으로도, HBM만으로도 설명되지 않는 병목이 바로 그 사이에 있기 때문이다.
다음에 읽을 글
패키징 병목을 이해했다면, 메모리 대역폭 자체가 AI 서버 성능을 어떻게 제한하는지도 함께 보면 좋습니다. AI 서버 메모리 병목의 전체 지도는 HBM의 역할과 XPU, HBF·HBS, CXL까지 메모리 계층 경쟁을 설명합니다.
체크포인트
- HBM 스택 제작과 GPU-HBM 통합 패키징을 구분했는가
- HBM4 공급망의 여섯 단계와 각 단계의 병목 요인을 이해했는가
- TC본더가 적층 속도와 수율에 동시에 영향을 주는 이유를 알겠는가
- 인터포저와 기판의 계층 차이와 유리 소재의 트레이드오프를 구분했는가
- 초박형 칩 적층 연구의 “4배”가 제품 성능 비교가 아님을 이해했는가
- 칩 발표와 실제 서버 출하 사이에 패키징 병목이 있을 수 있음을 고려했는가
확인한 출처 / 근거
- TrendForce, AI supply chain enters a new phase in 2026 — 2.5D 패키징 공급 제약과 AI 가속기 공급망 전망을 다룬 시장 분석.
- SemiAnalysis, ECTC 2026 — HBM4 패키징, 전력 공급, 냉각 과제를 다룬 기술 분석.
- TrendForce, Intel’s EMIB reportedly gains traction — CoWoS 외 첨단 패키징 대안과 수율 보도를 정리한 2차 자료.
- Samsung Semiconductor, HBM4 — HBM4 대역폭·I/O와 1c D램·4nm 베이스 다이 설명.
- SK hynix, HBM4 — 2K I/O 기반 차세대 HBM4 제품 설명.
- ZDNet Korea, 삼성전자·ASMPT TC본더 공동평가프로젝트 관련 보도 — HBM용 TC본더 공급망 다변화 움직임.
- 아주경제, HBM4 TC본더 정밀도·열 제어 관련 보도 — TC본딩 공정 난이도 배경.
- 서울경제, HBM4용 TC본더 공급계약 관련 보도 — 한미반도체·SK하이닉스 공급계약.
- 머니투데이, HBM4 전용 TC본더 4 생산·공급 관련 보도 — HBM4 전용 장비 공급 계획.
- TSMC 3DFabric, CoWoS — CoWoS 구조와 리티클 지원 범위의 1차 자료.
- JEDEC, JESD270-4 HBM4 — HBM4 표준 문서.
- TSMC 3DFabric, SoIC — 3D 적층 본딩 기술의 1차 자료.
- Intel, “Intel Unveils Industry-Leading Glass Substrates to Meet Demand for More Powerful Compute” — 유리기판의 평탄도·열기계 안정성·배선 밀도에 관한 공식 설명.
- Intel Foundry, “How Intel Foundry Packaging Technologies Redefine AI and HPC Scalability Limits at ECTC 2026” — TGV·저휨 특성과 대형 AI 패키지 적용 구조.
- EDN, “Five facts you need to grasp to understand Intel’s glass substrate” — 유리기판의 장점과 제조 과제 해설.
- 삼성전기, 「패키지 기판용 ‘글라스 코어’ 합작법인 설립 검토 MOU」 — 삼성전기·스미토모화학그룹·동우화인켐의 협력 배경.
- DART, 삼성전기 타법인주식및출자증권취득결정 — 글라셈 출자액 3,191억 원과 취득 후 지분율 66.2%의 1차 공시.
- POSTECH, 초박형 칩 10층 이상 적층 연구 보도자료 — 연구 조건과 적용 가능성을 설명한 대학 공식 자료.
- Results in Engineering 논문 원문 — 전사 프린팅과 인시투 접합 공정의 실험 결과를 담은 논문.
- DOI 10.1016/j.rineng.2026.111194 — 논문의 영구 식별 링크.
패키징 생산능력과 차세대 HBM 적층 수치는 시장조사업체 및 기술 분석사의 전망으로, 실제 고객별 공급량을 공개한 자료가 아닙니다. 12단 HBM 대비 집적도 비교는 연구진과 POSTECH이 제시한 설명으로, 실제 HBM 양산 공정의 수율·열 특성·비용까지 검증한 결과로 해석해서는 안 됩니다.