HBM4 너머의 AI 메모리 경쟁: 인텔 XBM·ZAM, 삼성 zHBM, 퀄컴 HBC까지
인텔 XBM·ZAM, 삼성 zHBM, 퀄컴 HBC가 HBM 중심 AI 메모리 시장에 던지는 질문을 패키징, 인터커넥트, 3D 적층, 근접 메모리 관점에서 정리합니다. 발표 목표치와 검증된 사양을 구분해 읽는 법도 함께 담았습니다.

이 글은 HBM 너머의 AI 메모리 설계 경쟁을 이해하기 위한 QSike Tech Notes 기술 해설입니다. 특정 기업 평가가 아니라 패키징, 인터커넥트, 3D 적층, 근접 메모리 구조 이해에 초점을 둡니다.
AI 반도체를 볼 때 많은 사람들이 GPU 성능부터 봅니다. 하지만 요즘 병목은 연산장치만의 문제가 아닙니다. GPU가 아무리 빨라도 데이터를 제때 공급하지 못하면 성능은 막힙니다. 그래서 HBM, 특히 HBM3E와 HBM4가 AI 인프라의 핵심 부품이 됐습니다.
그런데 2026년 들어 HBM 바깥쪽에서 새로운 설계 축이 잇달아 등장했습니다. 인텔의 XBM 특허와 소프트뱅크 계열 사이메모리와 협력하는 ZAM(Z-Angle Memory), 삼성전자가 FMS 2026에서 공개한 zHBM 콘셉트, 퀄컴이 데이터센터 로드맵에 넣은 **HBC(High Bandwidth Compute)**까지 네 개의 약어가 한 해 안에 나왔습니다.
기사 제목만 보면 “HBM4 대체” 또는 “HBM 대항마”가 곧 현실이 되는 것처럼 느껴집니다. 하지만 결론부터 말하면, 이들은 당장 HBM4를 밀어내는 제품이라기보다 HBM 중심 AI 메모리 공식에 새로운 설계 축이 등장하고 있다는 신호로 보는 편이 안전합니다. 이 글은 네 가지를 하나의 지도에 놓고, 발표 목표치와 검증된 사양을 구분하는 법을 정리합니다.
참고: 이 글은 2026년 7월과 8월에 각각 발행된 인텔 XBM·ZAM, 퀄컴 HBC, 삼성 zHBM 관련 글 세 편을 하나의 가이드로 재구성했습니다.
 XBM은 UCIe·BEOL DRAM·칩렛 패키지 축, ZAM은 Z축 3D 적층 메모리 축으로 이해하는 편이 안전하다.
인텔 XBM과 ZAM: 같은 인텔이지만 시간표가 다르다
먼저 인텔부터 봅니다. 인텔의 차세대 메모리 구상은 두 갈래로 알려져 있습니다. 하나는 인텔 특허로 공개된 XBM이고, 다른 하나는 사이메모리와 협력하는 ZAM입니다.
XBM은 무엇을 바꾸려 하나
위클리포스트는 XBM을 Cross-Batch Memory로 소개했습니다. 다만 TrendForce, Tom’s Hardware, Wccftech 등 영어권 보도에서는 정식 확장명보다 XBM이라는 약어 중심으로 다루고 있습니다. 원 특허 문서에서 명칭을 확인하기 전까지는 XBM 단독으로 부르는 편이 안전합니다.
XBM의 핵심은 기존 HBM과 다른 방식으로 메모리와 연산 칩을 연결하는 데 있습니다. 보도에 따르면 XBM은 UCIe(Universal Chiplet Interconnect Express) 인터페이스를 이용해 메모리와 연산 칩을 연결하고, Wccftech는 32GT/s급 연결을 언급했습니다.
여기서 중요한 단어는 UCIe입니다. UCIe는 서로 다른 칩렛을 하나의 패키지 안에서 연결하기 위한 표준 인터페이스입니다. 인텔이 XBM에 UCIe를 붙인다는 것은 메모리를 단품 부품이 아니라 칩렛 기반 AI 시스템의 일부로 보겠다는 뜻입니다. TrendForce와 Tom’s Hardware 보도에 따르면 XBM은 HBM4와 비슷한 패키지 면적을 겨냥하면서도, 실리콘 인터포저 부담을 줄이고 더 높은 밀도와 대역폭을 목표로 하는 구조로 소개됐습니다.
XBM에서 BEOL DRAM이 눈에 띄는 이유
가장 흥미로운 부분은 DRAM 셀을 어디에 배치하느냐입니다. 기존 DRAM은 트랜지스터를 실리콘 전면 공정, 즉 FEOL 영역에 배치합니다. 반면 XBM은 BEOL(Back-End-Of-Line) 영역의 트랜지스터 DRAM 적층을 활용하는 방향으로 보도됐습니다.
메모리 셀을 기존 방식과 다른 층에 배치하면, TSV 같은 수직 연결 구조와 배선 공간을 다르게 설계할 수 있습니다. HBM은 여러 DRAM 다이를 쌓고 TSV로 연결합니다. 이 구조는 대역폭을 크게 올려주지만, 면적, 배선, 전력, 수율 부담이 함께 따라옵니다. XBM이 노리는 지점은 바로 이 부담입니다. 더 많은 연결 통로를 만들고, 인터커넥트 효율을 높이며, HBM 구조가 가진 비용과 전력 문제를 줄이겠다는 방향입니다.
ZAM은 XBM과 무엇이 다른가
ZAM은 Z-Angle Memory로 불립니다. CNBC, TechPowerUp, TweakTown, Tom’s Hardware, TrendForce, HPCwire, Wccftech 등 여러 해외 매체가 인텔과 사이메모리의 협력, 프로토타입, 일본 정부 보조금, 대만 PSMC 참여를 보도했습니다.
ZAM의 방향은 XBM과 조금 다릅니다. XBM이 UCIe와 BEOL DRAM을 활용해 칩렛 패키지 안에서 메모리와 연산 칩을 효율적으로 연결하려는 접근이라면, ZAM은 Z축 방향의 3D 적층 구조로 HBM의 대역폭, 용량, 전력 병목을 풀려는 접근에 가깝습니다. TrendForce는 ZAM 기반 제품을 **HB3DM(High Bandwidth 3D Memory)**으로 언급했고, 9-Layer Via-in-One Architecture와 PSMC 참여도 보도됐습니다. ZAM 기반 HB3DM이 HBM4 대비 두 배 이상의 대역폭을 목표로 한다는 보도도 있지만, 이 수치는 초기 개발·프로토타입 단계의 목표치로 읽어야 합니다.
중요한 점은 타임라인입니다. TweakTown은 ZAM 프로토타입과 2028년 HBM 경쟁 목표를 보도했습니다. 반면 XBM은 TrendForce 기준으로 2030년 이후 상용화 가능성이 언급됩니다. 따라서 둘을 하나의 시간표로 묶어 “2030년 이후”라고 쓰는 것은 정확하지 않습니다.
ZAM은 2028년을 겨냥한 초기 경쟁 카드, XBM은 2030년대 이후 구조 변화를 노리는 장기 특허 카드로 나눠 보는 편이 더 맞습니다.
삼성 zHBM: 공식 콘셉트지만 표준도 제품도 아니다
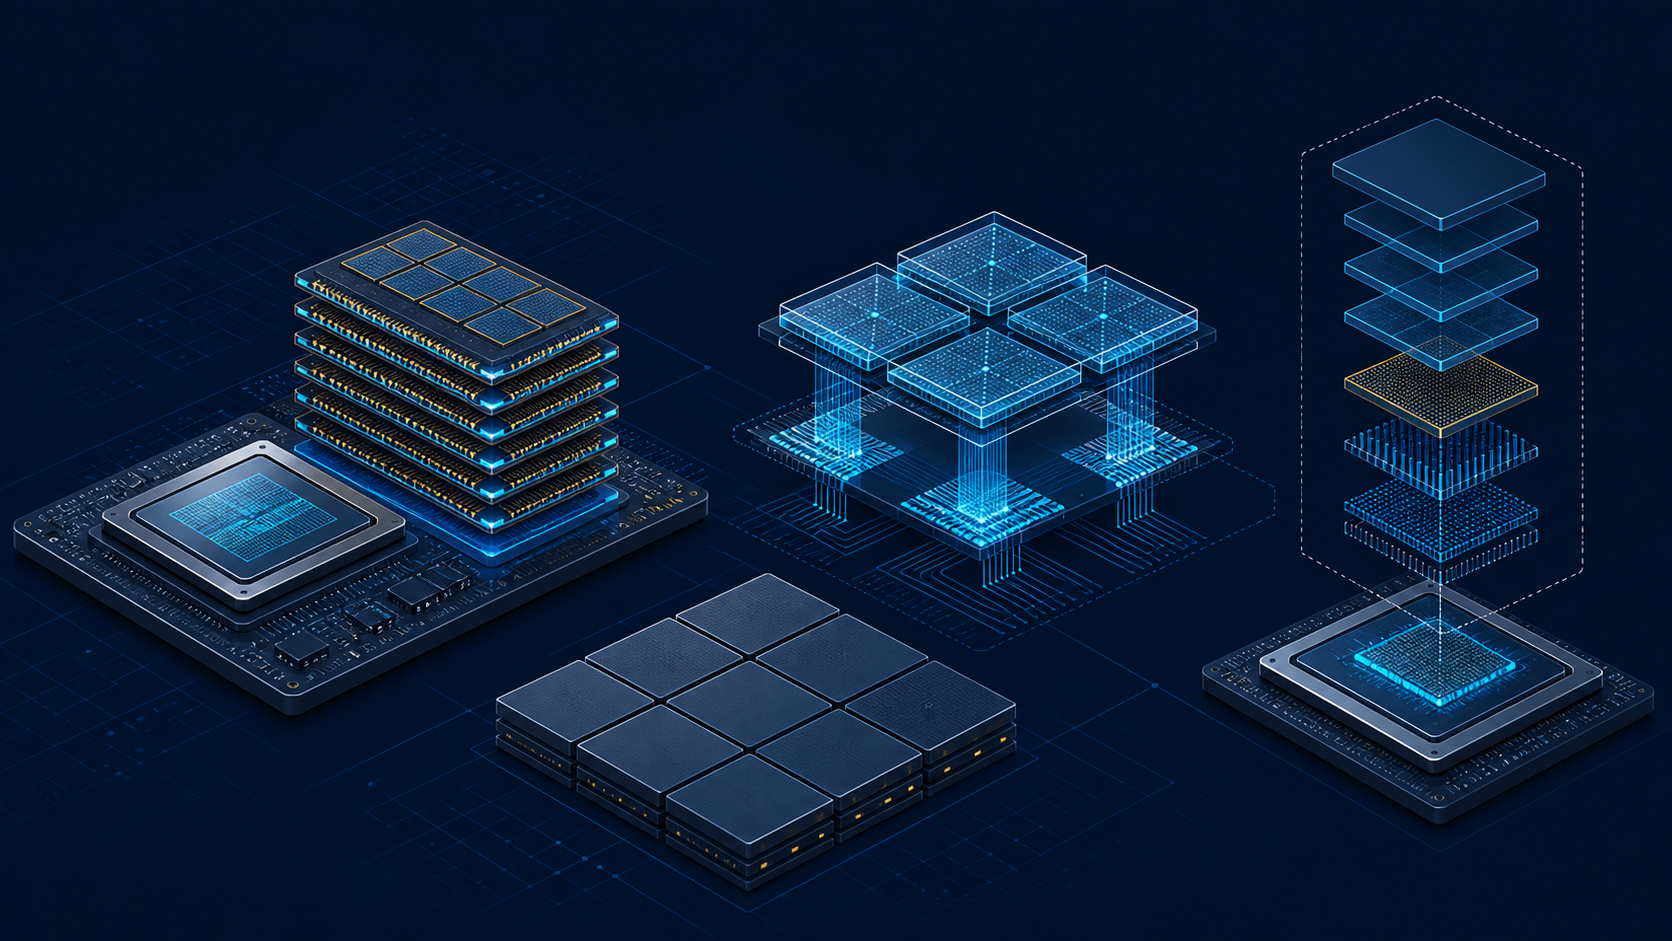
같은 z축 적층 경쟁에 삼성전자도 들어왔습니다. 삼성전자는 FMS 2026 키노트에서 zHBM과 zNAND-O를 “업계 최초의 콘셉트 모델”로 공개했습니다. 공식 발표에 따른 정의는 이렇습니다. zHBM은 HBM 스택을 AI 가속기 옆이 아니라 가속기 바로 위(z축)에 수직 적층하는 메모리 아키텍처입니다. 데이터 이동 거리를 최소화해 대역폭과 전력 효율을 올리겠다는 접근입니다.
삼성은 zHBM이 적용된 차세대 인터페이스 시스템이 “HBM5 대비 약 8배 성능”을 낼 것이라고 발표했고, 웨이퍼 본딩 기술로 HBM5 대비 10배 이상 메모리 밀도, 3배 에너지 효율, 절반 이하 열저항을 목표치로 제시했습니다. 이 수치들은 모두 삼성 발표 기준의 목표치이며, 데이터시트나 고객 검증으로 확인된 사양이 아닙니다.
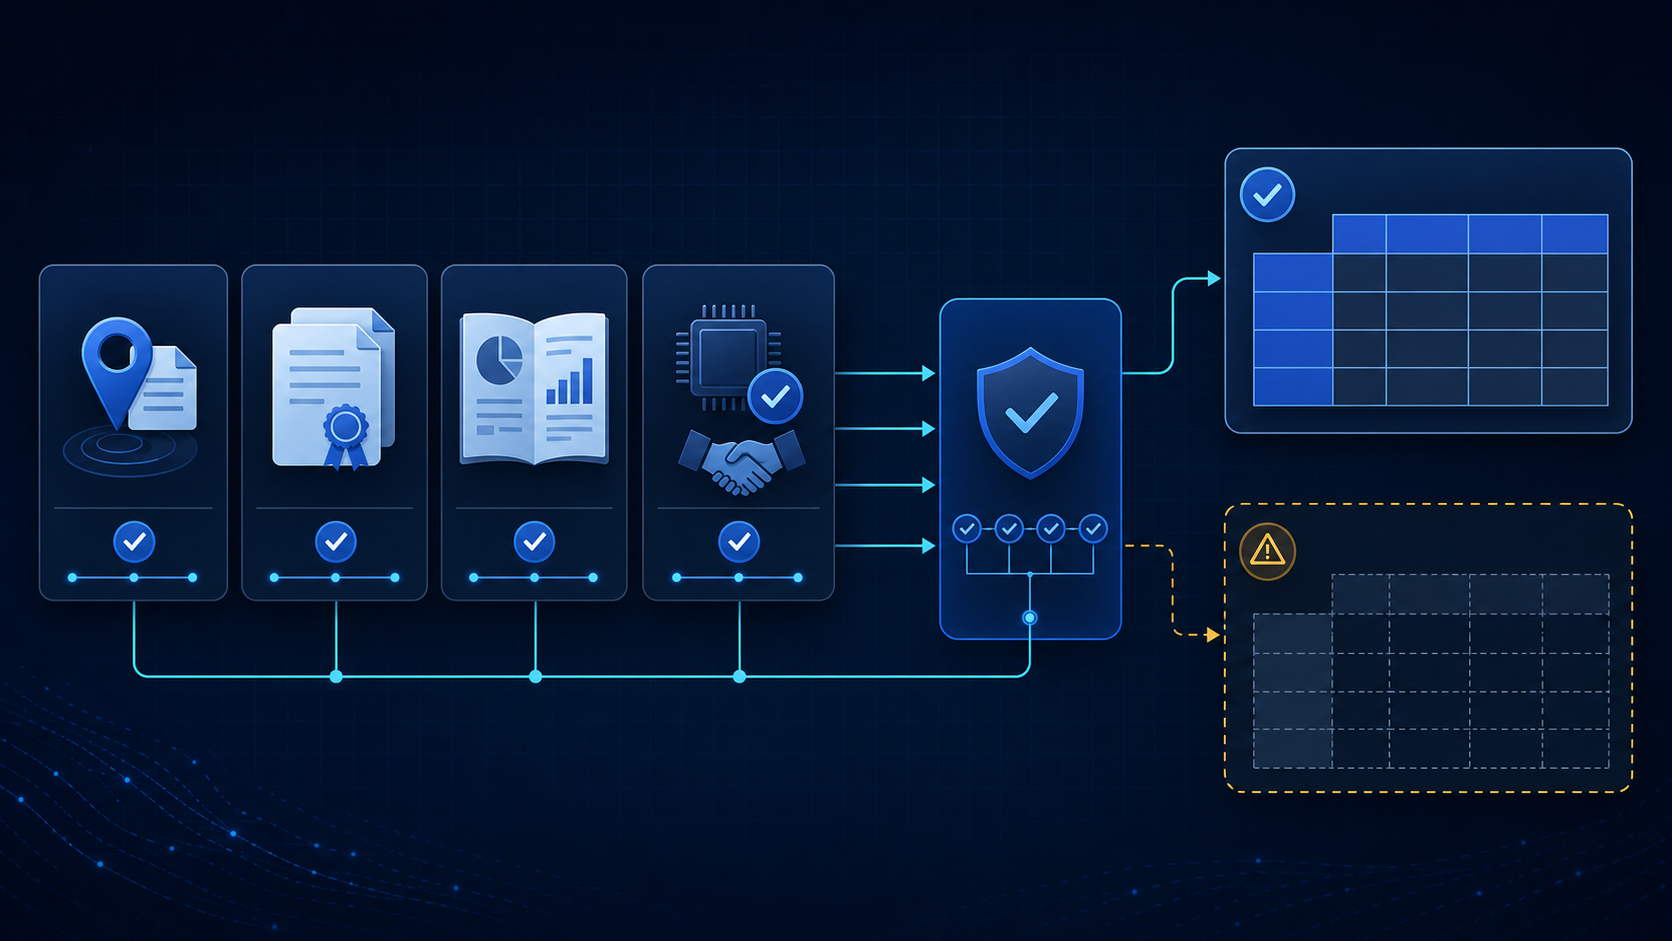
실무 체크로 네 항목을 묻고 시작하면 좋습니다. (1) 누가 명명했는가 — 삼성전자 공식 뉴스룸입니다. (2) JEDEC 호환인가 독자 규격인가 — 현 시점에 JEDEC 표준으로 확인되지 않는 독자 콘셉트입니다. (3) I/O 폭, 핀 속도, 용량, 적층, 전력, 패키지 조건이 공개됐는가 — 개념 목표치만 있고 데이터시트 수준의 사양은 미공개입니다. (4) 어떤 가속기와 고객 검증을 거쳤는가 — 미공개입니다. 네 항목 중 (3)과 (4)가 비어 있으므로, “zHBM은 기존 HBM보다 몇 배 빠르다”를 확정 사실처럼 쓰거나 “HBM4E를 대체한다”고 단정하는 문장은 보고서에 넣지 않는 것이 안전합니다.
퀄컴 HBC와 Dragonfly: 연산을 메모리 가까이로
축의 방향을 아예 바꾸는 접근도 있습니다. 퀄컴이 2026년 6월 인베스터 데이에서 공개한 HBC, High Bandwidth Compute입니다. HBM이 메모리를 넓고 빠르게 붙여 대역폭을 키우는 방식이라면, 퀄컴의 HBC는 연산을 메모리 가까이 가져가는 구조에 가깝습니다. 데이터를 멀리 옮기는 비용을 줄이고, 메모리 병목을 다른 방식으로 풀어보겠다는 접근입니다.
Dragonfly 로드맵의 핵심은 세 가지입니다. 첫째, Dragonfly C1000 CPU입니다. AI 에이전트, 범용 서버, AI 헤드노드 워크로드용 데이터센터 CPU로, 250개 이상의 코어를 가진 칩렛 구조, 자체 설계한 5GHz급 Oryon 코어, 기존 서버 CPU 대비 성능당 전력 효율 2배 이상 개선을 목표로 강조했고 상용화 시점은 2028년으로 제시됐습니다. 둘째, Dragonfly AI300 추론 가속기입니다. AI200과 AI250을 잇는 3세대 추론 가속기로, HBC Gen 2를 통합해 기존 GPU 기반 구조 대비 메모리 대역폭당 전력 효율에서 4~8배 수준의 개선을 기대한다고 밝혔습니다. 셋째, HBC 아키텍처 자체입니다. 3D 적층(real-silicon) 기반 근접 메모리 컴퓨팅 구조로, 연산 칩을 DRAM과 3D로 적층해 배치합니다.
퀄컴이 공개한 설계 목표를 따르면, AI250은 HBC Gen 1을 사용해 카드당 133 TB/s 수준의 유효 메모리 대역폭을 목표로 합니다. LPDDR5X 기반 AI200 대비 18배 증가한 수치로 제시됐고, AI300의 HBC Gen 2는 AI200 대비 54배 증가를 목표로 합니다. HBC가 HBM 대비 대역폭당 전력 효율에서 6배, 온칩 SRAM 대비 용량당 전력 효율에서 200배 개선을 설계 목표로 삼고 있다고도 밝혔습니다. HBC Gen 1 기반 AI250 샘플링은 2027년 중반, AI300은 2028년으로 언급됐습니다. 이 수치들은 모두 발표·설계 목표이며, 실제 워크로드에서 확인되려면 샘플과 독립 벤치마크가 필요합니다.
 핵심은 대체가 아니라 보완이다. 학습 중심 HBM과 추론 중심 근접 메모리 구조는 서로 다른 병목을 겨냥한다.
HBC는 HBM의 대체재일까
단기적으로는 그렇지 않을 가능성이 큽니다. 현재 AI 학습 시장은 여전히 HBM 중심입니다. 엔비디아 GPU, AMD GPU, 주요 AI 가속기 생태계는 HBM 공급 능력, 패키징, CoWoS·2.5D 인터포저, 전력·열 설계와 강하게 묶여 있습니다.
하지만 HBC가 의미 없는 기술이라는 뜻은 아닙니다. 학습은 거대한 모델을 한 번에 많이 계산하는 쪽에 가깝습니다. 반면 추론, 특히 에이전트형 AI 추론은 수많은 요청을 낮은 지연시간과 낮은 전력으로 처리해야 합니다. 이때는 단순 최고 성능보다 성능당 전력, 메모리 접근 효율, 서버 전체 TCO가 더 중요해집니다. 퀄컴이 모바일에서 쌓아온 저전력 설계, 온디바이스 AI, LPDDR 기반 메모리 활용 경험을 데이터센터로 확장하려는 전략으로 볼 수 있는 이유입니다.
퀄컴은 Dragonfly C1000과 관련해 메타와의 다세대 전략적 파트너십도 발표했습니다. 데이터센터 고객들이 특정 GPU 플랫폼 하나에만 의존하지 않고 워크로드별로 CPU, 추론 가속기, 네트워크, 메모리 구조를 나눠 최적화하려는 흐름과 맞닿아 있습니다. 메모리 업체 입장에서는 고객 지형이 넓어질 수 있습니다. 기존 GPU 중심 HBM 고객, 자체 AI 칩을 만드는 클라우드 사업자, 저전력 AI 가속기 업체, 추론 전용 랙 시스템 업체가 모두 다른 요구를 낼 수 있고, 이는 수요의 양뿐 아니라 HBM, 고성능 DDR, LPDDR, CXL 메모리, 커스텀 패키지가 나뉘어 쓰이는 제품 믹스에도 영향을 줍니다.
메모리 계층 지도: 누가 이기는가가 아니라 어디서 막히는가
네 가지 새 용어를 세대 순위표로 묶기 전에, 비교의 축을 병목으로 바꾸면 혼동이 줄어듭니다. 아래 표는 “누가 이기는가”가 아니라 “데이터가 어디에서 막히는가”를 기준으로 정리한 것입니다.
| 개념 | 계층·주로 푸는 문제 | HBM과의 관계를 읽는 안전한 방식 | 확인 수준(작성 시점) |
|---|---|---|---|
| HBM3E/HBM4/HBM4E | 가속기 인접 대역폭·용량 | 동일 계열 안의 세대·구현 비교. 제품별 공개 사양과 고객 인증을 확인한다. | 공급사 제품 페이지·발표 공개 |
| zHBM (삼성 콘셉트) | HBM을 가속기 위에 직접 적층해 이동 거리·대역폭·전력 한계 돌파 | 공식 콘셉트이지만 표준·제품은 아니다. 발표 수치(HBM5 대비 8배 등)는 목표치로만 읽는다. | 삼성 공식 발표(콘셉트) 공개, 데이터시트 미공개 |
| Z-Angle Memory (Intel·SAIMEMORY) | z축 적층으로 HBM의 열·적층 한계 돌파 | zHBM과 같은 z축 계열의 다른 구현. 경쟁 관계로 묶이되 표준·양산 시점은 미확정이다. | 프로토타입 공개 보도 단계 |
| HBC (퀄컴) | 추론 중심 워크로드의 데이터 이동 비용·전력 | HBM 대체가 아니라 보완 축. 학습 중심 HBM과 추론 중심 근접 메모리는 겨냥이 다르다. | 인베스터 데이 발표·설계 목표 단계 |
| CXL 기반 메모리 | 시스템 차원의 용량 확장·풀링·계층화 | HBM을 대체한다고 단정하지 않는다. 가까운 고대역폭 계층과 확장 계층은 병목이 다르다. | 공개 규격 생태계에서 확인 |
| HBS (SK hynix High Bandwidth Storage) | 스마트폰·온디바이스 AI에서 DRAM+NAND를 한 패키지에 적층해 공간·전력 제약 돌파 | HBM의 약자 변형이나 서버 스토리지 계층으로 읽지 않는다. 타깃은 온디바이스 AI이며 제품 정의는 공식 사양 확정 전이다. | 보도 수렴 단계, 공식 사양 미확정 |
| NVMe 기반 스토리지 | 대용량 데이터·체크포인트의 영구 보관과 이동 | 메모리 제품이 아니라 스토리지 인터페이스 사양 축. HBM과 같은 제품 축으로 뭉뚱그리지 않는다. | 공식 사양 공개 |
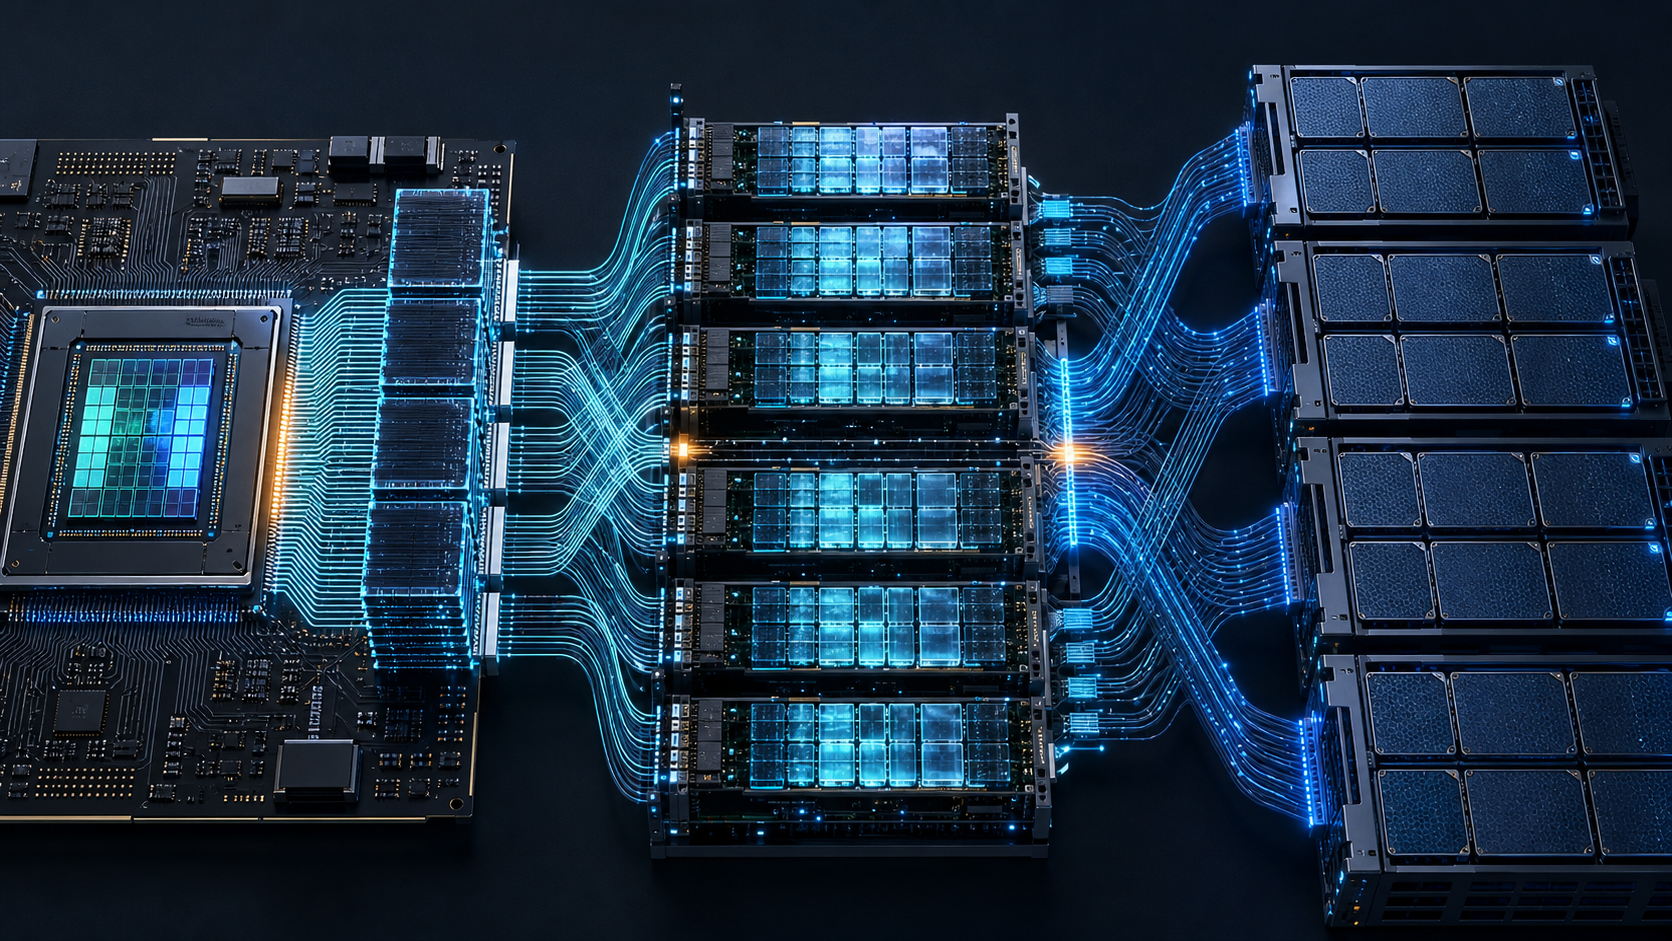
모델의 활성값과 파라미터를 가속기 가까이에서 계속 공급해야 한다면 HBM 계열, 그리고 그 한계를 넘으려는 zHBM·ZAM 류의 적층 콘셉트가 의미가 큽니다. 추론의 데이터 이동 비용과 전력이 문제라면 HBC 같은 근접 메모리 구조가 보완 축이 될 수 있습니다. 반대로 더 큰 데이터셋, 체크포인트, KV 캐시의 장기 보관과 이동, 서버 간 자원 활용이 문제라면 CXL·서버 DRAM·SSD 계층까지 함께 설계해야 합니다.
”HBM4 대체”라고 단정하기 어려운 이유
그렇다고 새 용어들을 곧바로 HBM4의 대체재로 보는 것은 이릅니다. 이유는 세 가지입니다.
첫째, 특허와 프로토타입과 콘셉트는 양산 제품이 아닙니다. 특허 공개와 초기 프로토타입은 기술 방향을 보여주지만, 실제 대량 생산의 성능, 수율, 비용을 보장하지 않습니다. AI 서버 시장에서 메모리는 성능만큼 안정성과 공급능력이 중요합니다.
둘째, HBM 생태계는 이미 강하게 형성되어 있습니다. GPU 업체, 메모리 업체, 패키징 업체, 파운드리, 서버 고객이 모두 HBM을 기준으로 설계와 검증을 진행하고 있습니다. HBM4는 아직 전환 초입이지만, 이미 로드맵과 고객 인증의 축이 만들어지고 있습니다.
셋째, 소프트웨어와 생태계의 벽이 있습니다. 새로운 메모리 아키텍처는 기술보다 생태계가 더 어렵습니다. 컴파일러, 런타임, 프레임워크 최적화, 모델 서빙 스택이 따라와야 하고, 데이터센터 고객은 안정성, 공급 지속성, 총소유비용이 검증돼야 본격 도입합니다. 3D 적층 실리콘, 근접 메모리 컴퓨팅, 고밀도 패키징은 수율과 열 관리도 까다롭습니다.
경쟁의 축이 넓어진다
XBM·ZAM·zHBM·HBC 보도를 “HBM의 역할이 끝난다”는 식으로 읽으면 위험합니다. 오히려 반대로 볼 필요가 있습니다. HBM이 너무 중요해졌기 때문에, 인텔과 삼성과 퀄컴이 제각기 다른 경로를 찾는 것입니다. 공급 부족, 높은 가격, 전력 부담, 패키징 복잡성이 커질수록 대체 구조에 대한 실험은 늘어납니다.
앞으로의 메모리 반도체 경쟁은 세 갈래로 나뉠 가능성이 큽니다.
첫째, 학습과 초대형 모델 중심의 HBM 고도화입니다. HBM3E, HBM4, HBM4E, 더 높은 적층, 더 넓은 대역폭, 더 어려운 패키징 경쟁은 계속됩니다.
둘째, 추론과 저전력 서버 중심의 LPDDR·고효율 메모리 재평가입니다. 전력과 비용이 중요한 AI 추론에서는 HBM이 아닌 다른 메모리 구조도 의미를 가질 수 있습니다. LPDDR은 원래 모바일·노트북 중심 메모리였지만, 전력 효율이 중요한 AI 추론 서버에서 다시 주목받을 수 있고, HBC가 확산되면 가속기와 가까운 위치에서 동작하는 커스텀 패키지 수요도 커집니다.
셋째, 로직과 메모리를 가까이 붙이는 근접 메모리·3D 패키징 경쟁입니다. zHBM, ZAM, XBM, HBC가 모두 이 축 위에 있습니다. 메모리 대역폭당 전력 효율, 패키지 내 연산과 메모리의 거리, 3D 적층 및 본딩 기술, 메모리 컨트롤러와 연산 로직의 결합도가 함께 중요해집니다.
여기에 지정학적 의미도 있습니다. ZAM 구도는 인텔의 미국, 사이메모리의 일본, PSMC의 대만이 함께 움직이는 형태입니다. 삼성전자와 SK하이닉스가 주도해온 HBM 시장에 대해 미국, 일본, 대만 축이 다른 경로를 모색하는 그림으로도 읽힙니다. 인텔 입장에서 XBM과 ZAM은 단순한 메모리 기술이 아니라 CPU, 패키징, 파운드리, 칩렛 인터커넥트에서 강점을 만들려는 시도이기도 합니다.
 앞으로는 좋은 DRAM을 많이 만드는 것뿐 아니라, AI 시스템 안에서 메모리가 연산과 어떻게 결합되는지가 중요해질 수 있다.
이 변화는 메모리 기업에도 중요한 질문을 던집니다. HBM4 경쟁은 계속되겠지만, 장기적으로는 메모리 업체가 단순 DRAM 공급자가 아니라 AI 시스템 아키텍처의 일부가 되어야 한다는 압력이 커집니다. 고객이 원하는 것은 메모리 칩 하나가 아니라, 전력, 대역폭, 용량, 패키징을 함께 만족하는 솔루션이기 때문입니다.
새 메모리 용어를 만났을 때의 체크 질문
이 글의 방법을 자기 업무에 바로 적용할 수 있도록, 확인 질문으로 정리했습니다.
새 용어를 만났을 때
- 이 이름은 누가 명명했는가 — 표준 기구, 제조사, 시장(미디어·증권가)?
- JEDEC 표준 또는 공개된 독자 규격 문서가 있는가?
- I/O 폭, 핀 속도, 용량, 적층, 전력, 패키지 조건이 데이터시트 수준으로 공개됐는가?
- 어떤 가속기에서, 어떤 고객의 검증을 거쳤다는 발표가 있는가?
워크로드와 예산을 검토할 때
- 내 병목은 대역폭, 용량, 지연시간, 전력, 소프트웨어 이동 비용 중 어디인가?
- 가속기 옆에 꼭 있어야 할 데이터와, 아래 계층(CXL·DRAM·스토리지)으로 내려보낼 수 있는 데이터가 구분되어 있는가?
- 인용하려는 수치가 같은 공급사·같은 플랫폼·같은 측정 조건에서 나온 것인지 확인했는가?
1번부터 4번까지 중 하나라도 비어 있으면 그 용어는 비교표의 행이 아니라 “검증 대기” 항목으로 남겨두는 편이 안전합니다. zHBM은 1번은 통과했지만(삼성 공식 명명) 2번이 표준 아님, 3번과 4번이 비어 있어 이 글에서도 검증 대기로 둡니다. XBM, ZAM, HBC도 같은 잣대로 읽을 수 있습니다.
한 문장 요약
인텔 XBM·ZAM, 삼성 zHBM, 퀄컴 HBC는 당장 HBM4를 대체하는 제품이라기보다, AI 메모리 병목을 풀기 위한 칩렛·패키징·3D 적층·근접 메모리 중심의 장기 실험입니다. ZAM은 2028년 경쟁 목표, XBM은 2030년대 이후 상용화 가능성으로 시간표를 나눠 보고, zHBM과 HBC는 발표 목표치와 검증 사양을 구분해서 읽어야 합니다.
독자에게 남기는 질문
AI 메모리 시장은 앞으로도 HBM 중심으로만 흘러갈까요, 아니면 추론 워크로드 확대와 함께 z축 적층, LPDDR, 근접 메모리, 커스텀 패키지가 새로운 축으로 커질까요?
확인한 출처 / 근거
인텔 XBM·ZAM 관련
- 미국 특허출원 공개 US 2026/0191095, XBM 관련 명세서 — XBM 구조를 확인할 수 있는 공개 특허출원 문서.
- Tom’s Hardware, Intel patent reveals new XBM memory architecture — BEOL 트랜지스터 DRAM 적층, UCIe 연결, 인터포저 제거 방향을 해설한 2차 자료.
- Intel, Intel and SoftBank subsidiary SAIMEMORY collaborate — ZAM 공동 개발의 목적과 역할을 설명한 Intel 공식 글.
- NEDO, 차세대 메모리 개발 사업 자료 — 일본 정부 지원 사업의 범위와 목표를 확인할 수 있는 공식 자료(PDF).
- TrendForce, ZAM-based HB3DM bandwidth report — HBM4 대비 대역폭 목표를 전한 2차 보도.
- TrendForce, 9-layer Via-in-One architecture report — PSMC 참여와 9층 시연 계획을 전한 2차 보도.
삼성 zHBM 관련
- 삼성 뉴스룸, “Samsung Unveils Next-Gen 3D-Memory Vision at FMS 2026, Charting the Future of AI Infrastructure”, 2026-08-05 — zHBM 콘셉트의 공식 1차 출처.
- JEDEC, “JESD238 High Bandwidth Memory (HBM3) DRAM” — HBM 계열 표준 문서 체계 확인.
- Samsung Semiconductor, “HBM3E 제품 페이지” 및 “HBM4 제품 페이지” — 세대별 제품 사양 확인.
- SK hynix 뉴스룸, “SK hynix Completes World’s First HBM4 Development and Readies Mass Production”, 2025-09-12 및 “SK hynix Ships Samples of 12-Layer Next-Gen ‘HBM4E’”, 2026-06-18 — HBM4·HBM4E 공급사 발표.
- TrendForce, “Breaking HBM Barriers: Samsung’s zHBM vs. Intel’s Z-Angle Memory”, 2026-02-18 — zHBM과 ZAM의 관계를 정리한 2차 자료.
퀄컴 HBC·Dragonfly 관련
- Qualcomm, Comprehensive Data Center Roadmap for the Agentic AI Era — Dragonfly와 HBC의 구조, 성능 목표, 샘플 일정을 담은 공식 발표.
- Qualcomm, Qualcomm and Meta Announce Strategic Multi-Generation Agreement — Meta와의 데이터센터 CPU 협력을 확인할 수 있는 공식 발표.
- Qualcomm, Qualcomm Accelerates Diversification with Comprehensive Strategy — 데이터센터 사업 목표를 포함한 회사 발표.
- Tom’s Hardware, Qualcomm reveals HBC near-memory AI architecture — HBC의 구조와 회사가 제시한 비교 수치를 해설한 2차 자료.
기타 계층 확인용
- Compute Express Link Consortium, “CXL Specification” — CXL 계층의 공개 규격.
- TrendForce, “SK hynix Reportedly Explores High-Bandwidth Storage Stacking NAND and DRAM”, 2025-11-11 — HBS 관련 보도 수렴 자료.
- NVM Express, “Specifications” — NVMe 스토리지 인터페이스 사양.
XBM은 공개 특허출원에서 확인되는 개념이며 Intel의 상용 제품 또는 로드맵 발표가 아닙니다. 2030년 이후 상용화 전망과 ZAM의 대역폭·출시 시점도 보도 또는 개발 목표일 뿐, 양산으로 검증된 결과가 아닙니다. zHBM의 8배·10배 수치는 삼성 발표 기준 목표치, 퀄컴의 133 TB/s·18배·54배·6배·200배 수치는 발표·설계 목표이며 실제 독립 벤치마크로 확인되지 않았습니다. “HBC나 zHBM이 HBM을 대체한다”는 단정은 피했습니다.
다음에 읽을 글
메모리 기술 구조를 봤다면, 시장과 수익 구조도 함께 볼 차례입니다. 삼성전자 2분기 실적과 메모리 마진은 HBM 경쟁이 실적표에 어떻게 나타나는지 정리합니다.
체크포인트
- XBM, ZAM, zHBM, HBC를 “HBM4 즉시 대체”가 아니라 각각 다른 설계 축으로 봤는가?
- XBM은 UCIe, BEOL DRAM, 칩렛 패키지 관점에서, ZAM은 Z축 3D 적층과 2028년 목표로 구분했는가?
- zHBM이 삼성 공식 콘셉트지만 표준·데이터시트·고객 검증이 아니라는 점을 확인했는가?
- 퀄컴의 133 TB/s, 18배, 54배, 6배, 200배 수치가 발표·설계 목표라는 점을 구분했는가?
- 특허·프로토타입·콘셉트 단계와 양산 제품의 고객 인증·수율·비용이 다르다는 점을 구분했는가?
- 학습 중심 HBM과 추론 중심 근접 메모리가 서로 다른 병목을 겨냥한다는 점을 이해했는가?