AX 인재는 PI 출신이 먼저인가, AI 개발자가 먼저인가
AX 추진에서 PI 역량을 가진 사람이 AI를 먼저 배워야 하는지, AI 개발자가 PI를 먼저 배워야 하는지 비교합니다. 초기 문제 정의는 PI가 이끌고 운영화·확산은 AI/플랫폼 인력과 짝을 이루는 구조를 정리합니다.
AX 과제 검토 회의에서 한 달 사이 세 번 받은 질문이 있다. “개발자를 더 뽑을까요, 아니면 프로세스 혁신 담당자에게 AI를 가르칠까요?” 회의실은 늘 둘로 나뉘었고, 답은 번번이 달라졌다. 돌이켜보면 진짜 문제는 답이 아니었다. 다들 다른 질문에 답하고 있었다는 것이다.
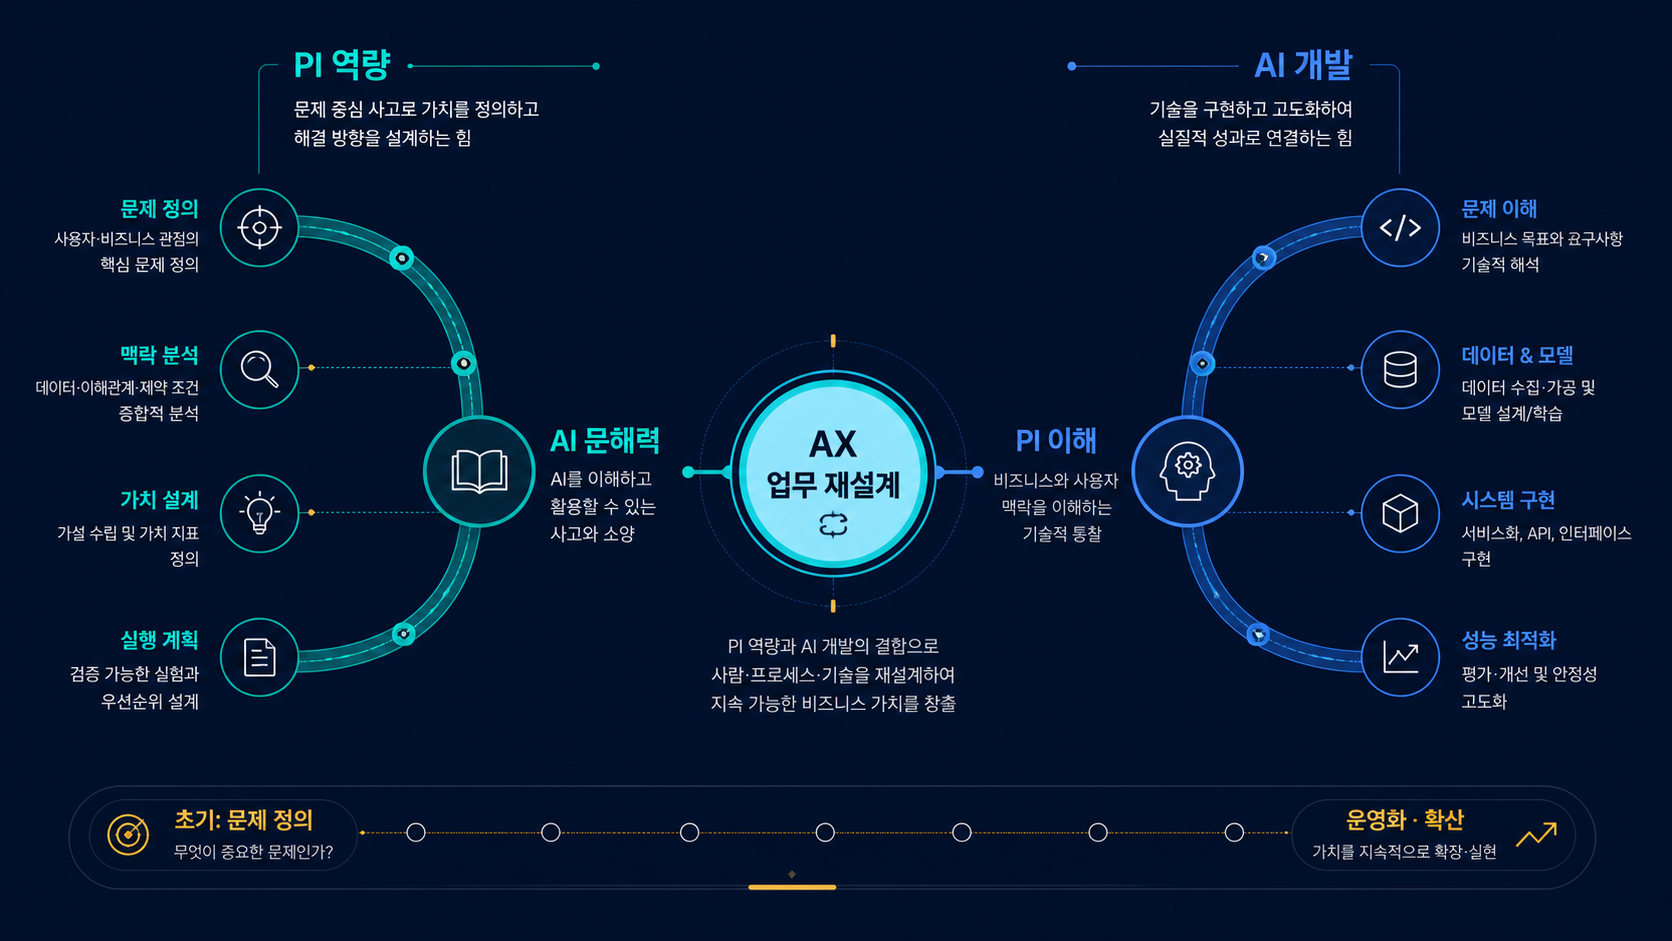
AX의 성패는 “누가 더 똑똑한 AI를 만들었는가”보다 “누가 업무를 AI가 실행 가능한 구조로 바꾸었는가”에서 갈린다. 그래서 출발점은 AI 개발자보다 Process Innovation 역량을 가진 사람에게 더 가깝다. 다만 확장과 운영은 AI/플랫폼 역량 없이는 오래가지 못한다.
같은 질문처럼 보이지만, 사실은 다른 질문이다
AX를 추진하다 보면 반복해서 만나는 질문이 있다.
Process Innovation 역량을 가진 사람이 AI를 배우게 할까? 아니면 AI 개발자에게 Process Innovation을 가르칠까?
겉으로 보면 인재 육성 방식의 선택처럼 보인다. 하지만 실제로는 AX를 무엇으로 보느냐의 질문이다.
AX를 “AI 기능을 업무 시스템에 붙이는 일”로 보면 AI 개발자가 출발점이 된다. 모델을 고르고, API를 붙이고, RAG를 만들고, 에이전트를 구성하고, 프롬프트와 도구 호출을 설계하는 일이 중심이기 때문이다.
반대로 AX를 “업무 운영 방식을 AI와 함께 일할 수 있게 다시 설계하는 일”로 보면 Process Innovation, 즉 PI 역량이 출발점이 된다. 어떤 업무가 반복되는지, 어떤 예외가 많은지, 어디서 승인이 필요한지, 실패하면 누구에게 비용이 발생하는지, 어떤 데이터가 실제 판단에 쓰이는지를 먼저 봐야 하기 때문이다.
내가 AX 현장을 볼 때 더 자주 부딪히는 병목은 후자에 가깝다. AI 모델을 호출하는 방법을 몰라서 멈추는 경우도 있지만, 그보다 더 자주 멈추는 지점은 “무엇을 AI에게 맡길 수 있는 단위로 쪼갤 것인가”다. 이 병목의 정체를 구체적으로 보려면, AI가 기업 업무를 만날 때 실제로 무슨 일이 일어나는지부터 봐야 한다.
AI는 업무를 자동으로 이해하지 않는다
AI를 도입하면 업무가 알아서 정리될 것처럼 기대하기 쉽다. 하지만 기업 업무는 문서화된 절차보다 실제 운영의 예외가 훨씬 많다.
예를 들어 구매 요청 검토 업무를 생각해보자. 겉으로는 간단해 보인다.
- 요청 내용을 읽는다.
- 예산을 확인한다.
- 기존 계약이나 공급사 정보를 본다.
- 승인 여부를 판단한다.
하지만 실제 현장에서는 질문이 훨씬 복잡해진다.
- 품목명이 표준화되어 있는가?
- 같은 품목을 부서마다 다르게 부르지 않는가?
- 예산 잔액은 어느 시스템에서 확인하는가?
- 예산이 부족할 때 대체 승인 경로가 있는가?
- 기존 계약이 있더라도 예외 구매가 가능한 조건은 무엇인가?
- AI가 초안을 만들 수 있는 단계와 사람이 반드시 승인해야 하는 단계는 어디인가?
이 질문에 답하지 못하면 AI 개발자가 아무리 좋은 에이전트를 만들어도 운영에 들어가기 어렵다. 반대로 PI 역량이 있는 사람은 이 질문들을 업무 흐름으로 볼 가능성이 높다. 현장의 입력, 처리, 판단, 승인, 예외, 피드백 루프를 해부하는 데 익숙하기 때문이다.
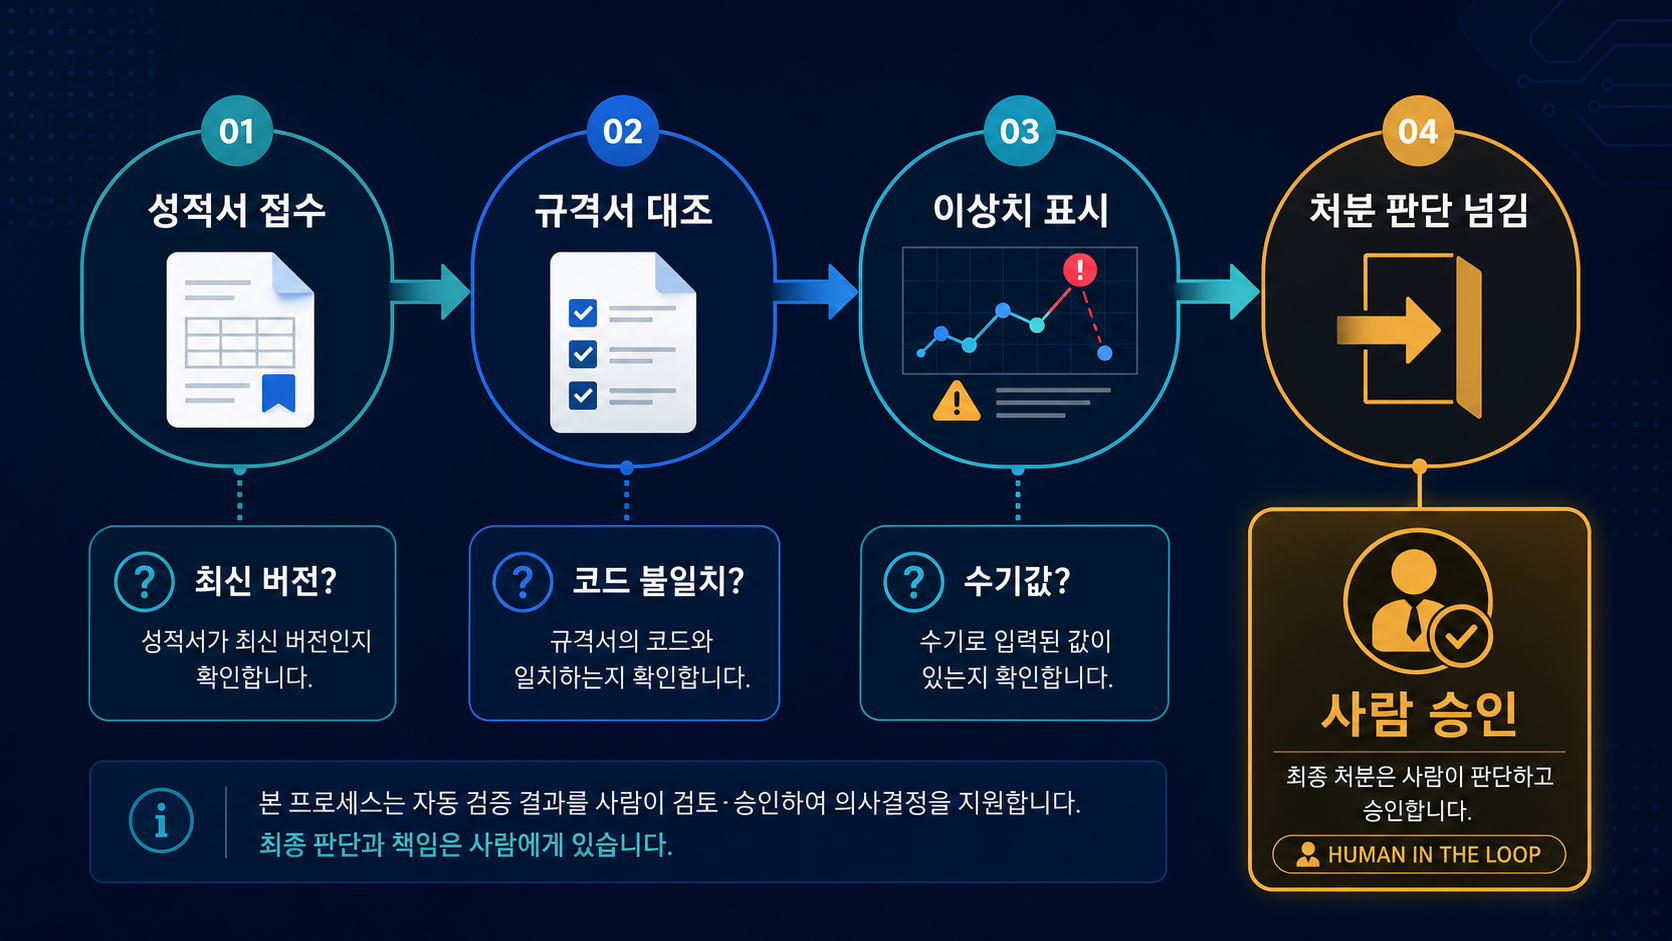
내가 맡았던 입고 검사 성적서 대조 업무가 딱 그랬다. 서류상으로는 단순한 일이었다. 공급사가 보낸 검사 성적서를 읽고, 규격서와 대조하고, 이상치를 표시하고, 처분 판단은 품질 담당 엔지니어에게 넘기면 끝이었다. 그런데 막상 AI에게 맡길 단위로 쪼개려 하자 질문이 쏟아졌다. 여러 시스템에 흩어진 규격서 중 어느 버전이 최신인지, 같은 품목 코드가 MES와 검사 시스템에서 서로 다른 값으로 존재하지는 않는지, 디지털 데이터가 아니라 수기로 남긴 측정값은 어떻게 읽을지, 이상치 발견 시 hold 처분 권한은 누구까지 갖는지. PoC 범위를 정할 수 있었던 것은 모델 성능이 아니라 이 질문들의 답을 업무 흐름 지도로 먼저 그려놓고 나서였다.
IBM은 프로세스 마이닝을 이벤트 로그 데이터에 알고리즘을 적용해 프로세스가 실제로 어떻게 흘러가는지의 패턴과 세부를 찾아내는 방법이라고 설명한다.[1] 이 정의는 AX에도 그대로 중요하다. AX의 출발점은 멋진 데모가 아니라, 실제 업무가 어디서 반복되고 어디서 막히는지 보는 일이다.
프로세스 마이닝 전문 기업 셀로니스(Celonis)의 표현을 빌리면, 프로세스 마이닝은 “프로세스가 실제로 어떻게 운영되는지를 보여준다 — 당신이 그렇게 운영된다고 생각하는 방식이 아니라”다.[2] 같은 페이지에서 재무, 공급망, 공유서비스 같은 운영 영역별로 프로세스 마이닝이 적용되는 사례도 함께 설명하는데, 이는 업무 흐름 분석이 특정 부서의 일이 아니라 운영 전반의 언어라는 뜻이기도 하다.
PI 출신이 AI를 배울 때의 강점
PI 역량을 가진 사람이 AI를 배우면 가장 큰 장점은 문제 정의가 빠르다는 것이다.
PI형 인재는 보통 업무를 기능 목록이 아니라 흐름으로 본다. “이 화면에 챗봇을 붙이자”보다 “이 업무에서 사람이 반복 판단하는 지점은 어디인가”를 묻는다. AX에서는 이 차이가 크다.
AI 에이전트가 업무를 수행하려면 다음 요소가 필요하다.
| AX 설계 요소 | PI 관점의 질문 | AI 관점의 구현 |
|---|---|---|
| 시작 조건 | 이 업무는 어떤 이벤트로 시작되는가 | 트리거, 입력 스키마 |
| 판단 기준 | 사람이 무엇을 보고 판단하는가 | 프롬프트, 규칙, 검색, 분류 모델 |
| 데이터 접근 | 어떤 시스템의 어떤 값이 필요한가 | API, RAG, DB 조회, 권한 위임 |
| 승인 경계 | 어디서 사람이 멈춰서 봐야 하는가 | human-in-the-loop, 승인 워크플로 |
| 예외 처리 | 실패하면 어떤 경로로 되돌리는가 | fallback, rollback, escalation |
| 성과 측정 | 무엇이 줄어야 성공인가 | 리드타임, 재작업률, 오류율, 처리량 |
PI 출신은 왼쪽 질문에 강하다. AI를 배우면 오른쪽 구현과 연결할 수 있다. 이때 필요한 AI 학습은 처음부터 모델 연구자가 되는 것이 아니다. 오히려 AX 현장에서는 다음 정도의 AI 문해력이 먼저 중요하다.
- LLM이 잘하는 일과 못하는 일의 경계
- RAG가 필요한 경우와 단순 프롬프트로 충분한 경우
- 에이전트가 도구를 호출할 때 필요한 입력·출력 형식
- 권한 위임과 로그가 필요한 이유
- 확률적 결과를 운영 프로세스 안에서 통제하는 방법
이 정도를 이해한 PI 인재는 AI 개발자에게 “무엇을 만들어달라”고 말하는 수준을 넘어, 업무를 AI가 실행 가능한 설계도로 바꿀 수 있다.
AI 개발자에게 PI를 가르칠 때의 강점
그렇다고 AI 개발자에게 PI를 가르치는 방식이 틀렸다는 뜻은 아니다. 오히려 확장 단계에서는 AI 개발자의 역할이 결정적이다.
AI 개발자는 구현 가능성과 운영 리스크를 빨리 본다. 어떤 데이터 접근 방식이 위험한지, 어떤 모델 호출이 비용을 키우는지, 에이전트가 어디서 불안정해질 수 있는지, 로그와 모니터링을 어떻게 남겨야 하는지를 판단할 수 있다.
IBM은 AI 에이전트를 “가용한 도구로 워크플로를 설계하며 자율적으로 업무를 수행하는 시스템”으로 설명한다.[3] 이 정의를 기업 안으로 가져오면 단순 챗봇과는 다른 요구가 생긴다. 에이전트는 데이터를 읽고, 도구를 호출하고, 중간 산출물을 만들고, 때로는 다음 액션을 제안한다. 이때 AI 개발자는 안전한 실행 구조를 설계해야 한다.
AI 개발자에게 PI를 가르치면 다음 장점이 있다.
- PoC가 실제 시스템 구조와 맞게 설계된다.
- 권한·로그·모니터링을 처음부터 고려한다.
- 데이터 품질과 API 제약을 현실적으로 반영한다.
- 반복 가능한 플랫폼 컴포넌트로 확장하기 쉽다.
PoC 설계서에 들어가야 할 운영 설계 요소 5가지
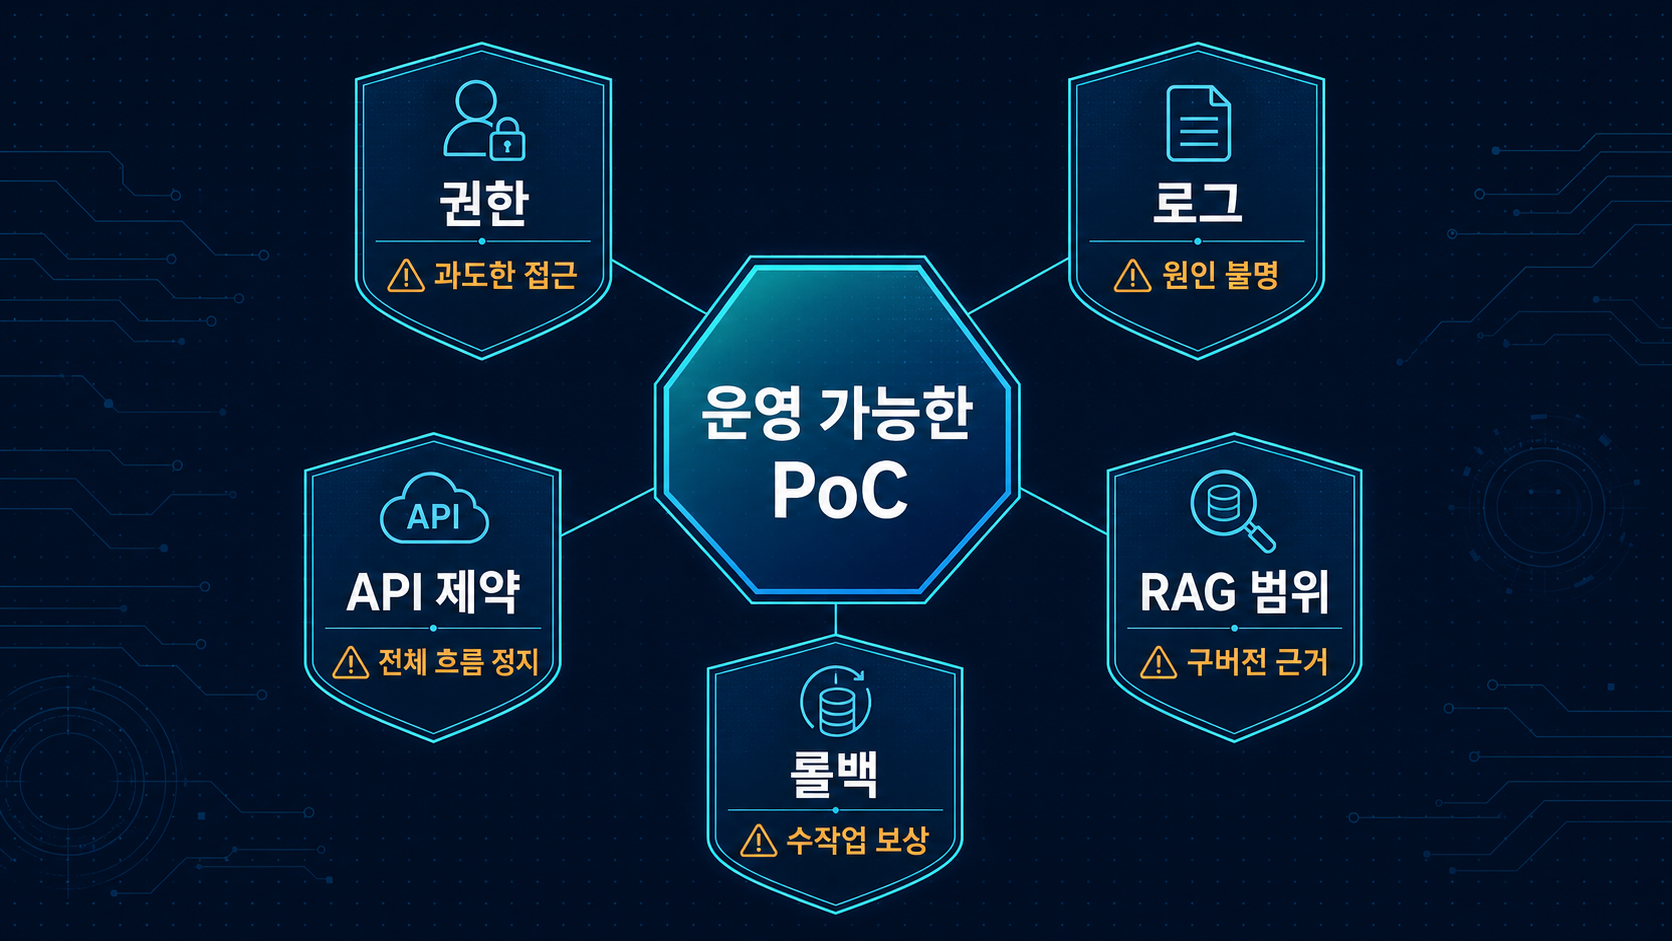
PI를 이해하는 AI 개발자가 설계하는 PoC라면, 첫 설계서부터 다음 다섯 가지가 보아야 한다. 내 경험에서는 이 다섯 항목이 설계서에 있는지가 살아남는 PoC와 사라지는 PoC를 갈랐다.
- 권한 — 에이전트가 작업 단위별로 필요한 최소 권한만 갖는가? 없으면 권한 밖 정보를 요구하거나 사람 승인 없이 다음 단계로 진행한다.
- 로그 — 무엇을 읽고, 무엇을 근거로 판단하고, 어떤 도구를 호출했는지 재구성할 수 있는가? 없으면 장애가 났을 때 원인 판단 자체가 불가능하다.
- API 제약 — 호출 한도, 오류 코드, 타임아웃 조건이 설계에 반영되어 있는가? 없으면 외부 시스템 장애 하나가 전체 워크플로를 멈춘다.
- RAG 범위 — 검색 대상 문서의 범위와 버전 기준이 고정되어 있는가? 없으면 답변이 구버전 문서를 근거로 만들어지고, 답이 매번 달라진다.
- 롤백 — 잘못 실행했을 때 실행 전 상태로 되돌리는 경로가 있는가? 없으면 되돌리기가 아니라 수작업 보상 처리가 된다.
이 다섯 항목을 체계적으로 점검할 때는 NIST AI Risk Management Framework가 좋은 체크리스트가 된다. AI RMF 1.0은 리스크 관리를 GOVERN(거버넌스)·MAP(리스크 맥락 파악)·MEASURE(측정)·MANAGE(관리) 네 기능으로 구성하는데, PoC 단계의 권한·로그·모니터링 설계를 이 네 기능에 대응시켜 점검하면 빠진 항목을 찾기 쉽다.[4][5] 참고: 이 구조는 RMF 1.0 기준이며, NIST는 현재 RMF 1.0 개정을 진행 중이다.
문제는 AI 개발자가 업무 맥락을 너무 늦게 배우면, AX가 “기술 데모”로 흐를 수 있다는 점이다. 프롬프트는 그럴듯하고 화면은 멋있지만, 현업의 실제 승인 경로와 예외 처리, 성과 지표가 빠진다. 이런 프로젝트는 데모룸에서는 좋아 보이지만 운영 현장에서는 오래 버티기 어렵다.
둘 중 하나만 고르면 생기는 실패 패턴
두 접근 모두 한쪽으로 치우치면 실패 패턴이 생긴다.
1. PI만 강하고 AI 이해가 약할 때
PI 출신이 업무 흐름을 잘 안다고 해서 자동으로 AX가 되는 것은 아니다. AI의 작동 방식을 모르면 기존 프로세스를 그대로 자동화하려는 유혹이 생긴다.
예를 들어 “사람이 하던 검토 절차를 AI에게 그대로 시키자”는 식이다. 하지만 AI는 사람처럼 암묵지를 안정적으로 재현하지 못한다. 입력 데이터가 불완전하면 흔들리고, 근거가 약하면 그럴듯한 답을 만들 수 있으며, 권한 밖 정보를 요구할 수도 있다.
이 경우 AX는 혁신이 아니라 위험한 자동화가 된다.
2. AI만 강하고 PI 이해가 약할 때
AI 개발자 중심으로만 가면 반대 문제가 생긴다. 기술적으로 가능한 것을 먼저 만들고, 나중에 업무 적용처를 찾는다.
이 방식은 빠른 데모에는 유리하다. 하지만 현장의 실제 병목과 맞지 않으면 사용자는 “신기하지만 내 일에는 안 맞는다”고 느낀다. 더 큰 문제는 성과 측정이 흐려진다는 점이다. 업무 리드타임이 줄었는지, 재작업이 줄었는지, 승인 품질이 좋아졌는지보다 “AI 기능을 몇 개 만들었는가”가 지표가 되기 쉽다.
AX는 기능 수가 아니라 운영 변화로 평가되어야 한다.
내 결론: 초기에는 PI형 인재가 AI를 배우는 편이 빠르다
둘 중 하나를 먼저 골라야 한다면, 나는 PI 역량을 가진 사람이 AI를 배우는 쪽이 AX 초기 추진에는 더 유리하다고 본다.
이유는 세 가지다.
첫째, AX의 첫 병목은 대개 모델 구현이 아니라 문제 선택이다. 어떤 업무를 AI 대상으로 삼을지, 어디까지 자동화하고 어디서 사람에게 넘길지, 어떤 예외를 제외할지 정하지 못하면 개발은 방향을 잃는다.
둘째, 현업 신뢰를 얻기 쉽다. AX는 현장의 일하는 방식을 바꾸는 일이기 때문에 “AI를 잘 아는 사람”보다 “내 업무를 이해하는 사람”에게 먼저 마음이 열린다. PI 출신은 현장 언어를 기술 언어로 번역하는 데 강하다.
셋째, 작은 성공을 반복하기 좋다. AX는 한 번에 전사 시스템을 바꾸는 방식보다, 업무 단위를 쪼개고 파일럿을 검증한 뒤 권한과 범위를 확장하는 방식이 현실적이다. PI형 인재는 이런 단계적 개선에 익숙하다.
다만 이 결론은 “AI 개발자는 나중에 불러도 된다”는 뜻이 아니다. 오히려 초기에 PI형 인재가 문제를 정의하더라도, AI/플랫폼 인력은 설계 초반부터 붙어야 한다. 그래야 PoC가 버려지는 데모가 아니라 운영 가능한 구조로 자란다.
AX 추진 조직은 T자형이 아니라 짝 구조가 필요하다
흔히 한 사람이 모든 것을 다 아는 T자형 인재를 말한다. 물론 이상적이다. 하지만 AX에서 PI, AI, 데이터, 보안, 시스템 통합, 현장 변화관리까지 한 사람이 모두 깊게 아는 것은 드물다.
그래서 현실적인 답은 “누구를 만능으로 만들 것인가”가 아니라 “어떤 짝을 만들 것인가”다.
| 단계 | 주도 역할 | 함께 붙어야 할 역할 | 핵심 산출물 |
|---|---|---|---|
| 문제 발굴 | PI/현업 혁신 인력 | 현업 리더, 데이터 담당 | 업무 흐름, 병목, 성과 지표 |
| AI 적용 설계 | PI형 AX 리드 | AI 개발자, 보안/권한 담당 | AI 작업 단위, 승인 경계, 예외 조건 |
| PoC 구현 | AI 개발자 | PI형 AX 리드, 현업 사용자 | 에이전트/워크플로, 로그, 테스트 케이스 |
| 운영화 | 플랫폼/IT | PI형 AX 리드, 운영 조직 | 모니터링, 권한 체계, 배포·변경 관리 |
| 확산 | AX CoE 또는 FDE 조직 | 각 부서 PI·현업 챔피언 | 재사용 패턴, 교육, 가이드 |
이 구조에서 PI 출신은 AI를 배워 AX 리드가 되고, AI 개발자는 PI를 배워 현실적인 구현 파트너가 된다. 방향은 다르지만 둘 다 상대 영역을 배워야 한다. 다만 AX 초기의 무게중심은 PI 쪽에 두는 편이 실패 확률을 낮춘다.
이 짝 구조에서 꼭 지켜야 할 운영 원칙 하나를 꼽자면, 초안과 검증의 분리다. 문제를 정의하는 사람과 구현하는 사람이 달라야 하듯, 결과의 성패 판단도 구현자 혼자 또는 정의자 혼자 내리면 안 된다. 독립적인 검증 역할을 둘 수 없다면, 최소한 운영 지표를 아는 현업 사용자에게 결과를 다시 확인하게 하는 절차를 두는 것이 좋다. 늦게 발견되는 PoC 실패를 되짚어보면, 내 경험상 내부 자가 검증을 그대로 통과한 경우가 적지 않았다.
실무적으로는 이렇게 나누는 것이 좋다
조직에서 실제로 육성한다면 다음처럼 나눌 수 있다.
PI 출신에게 먼저 가르칠 AI
- LLM과 기존 룰 기반 자동화의 차이
- 프롬프트보다 중요한 입력·출력 구조화
- RAG와 사내 데이터 연결의 기본 개념
- AI 에이전트의 도구 호출 방식
- hallucination, 권한 오남용, 로그 부재의 위험
- PoC를 운영 지표로 검증하는 방법
AI 개발자에게 먼저 가르칠 PI
- SIPOC, Value Stream, 병목 분석 같은 프로세스 사고
- 현업 인터뷰와 업무 관찰 방법
- 예외 처리와 승인 경계 도출
- 리드타임, 재작업률, 처리량, 오류율 같은 운영 지표
- 변경관리와 사용자 수용성
- 현장 언어를 기술 요구사항으로 바꾸는 방법
핵심은 교육 순서가 아니라 첫 프로젝트 배치다. PI 출신에게는 실제 AI PoC를 맡겨야 하고, AI 개발자에게는 실제 현장 인터뷰와 업무 관찰을 경험시켜야 한다. 강의만으로는 AX 역량이 생기지 않는다.
AX 리더가 던져야 할 체크 질문
이 글에서 딱 하나만 기억해야 한다면, 아래 여섯 질문이길 바란다. AX 과제 착수 첫 회의에서 이 질문을 던지면 대부분의 실패 패턴을 미리 걸러낼 수 있다.
- 이 과제의 업무 흐름은 문서가 아니라 실제 작업 현장에서 관찰되었는가?
- AI가 맡을 작업과 사람이 승인할 작업이 구분선으로 그려져 있는가?
- 예외 상황을 제외했기 때문에 PoC가 완성되어 보이는 것은 아닌가?
- 성공 지표는 “AI 기능 몇 개 출시”가 아니라 업무 성과(리드타임·재작업률·오류율)로 정의되어 있는가?
- 권한, 로그, 감사 추적, 롤백 조건이 두 번째 설계서가 아니라 첫 설계서에 들어갔는가?
- PI형 인재와 AI 개발자가 같은 문제를 보고 있는가, 아니면 서로 다른 산출물을 만들고 있는가?
이 질문에 답할 수 있으면 AX는 기술 도입이 아니라 운영 혁신에 가까워진다.
마무리: AX는 AI 프로젝트가 아니라 일의 재설계다
AX를 추진할 때 “PI 출신에게 AI를 가르칠까, AI 개발자에게 PI를 가르칠까”라는 질문에 대한 내 답은 이렇다.
초기 추진은 PI 역량을 가진 사람이 AI를 배우는 쪽이 더 빠르다. 그러나 운영화와 확산은 AI 개발자가 PI를 배우지 않으면 불가능하다.
AX는 AI를 잘 붙이는 프로젝트가 아니라, 업무를 AI와 사람이 함께 수행할 수 있도록 다시 설계하는 일이다. PI는 그 업무의 뼈대를 보고, AI 개발자는 그 뼈대가 실제로 움직이게 만든다. 둘 중 하나가 중심을 독점하면 AX는 데모나 문서로 끝난다.
결국 좋은 AX 조직은 “AI를 아는 PI 인재”와 “PI를 이해하는 AI 개발자”를 함께 키운다. 다만 첫 질문을 던지는 사람은 AI 모델보다 업무 흐름을 먼저 보는 사람이어야 한다.
이 글을 읽으며 당신의 조직에서 시작할 첫 AX 과제를 떠올렸다면, 마지막으로 이 질문을 남겨둔다. 그 과제의 예외와 승인 경계 지도를 그릴 사람은 누구인가? 그 답이 곧 당신 조직의 첫 투자가 AI 문해력인지 PI 문해력인지를 말해줄 것이다.
이 글은 공개 자료와 필자의 AX/업무자동화 관점을 바탕으로 재구성·각색한 글입니다. 특정 기업·종목에 대한 투자 판단이나 추천이 아닙니다.
확인한 출처 / 근거
- IBM, What is Process Mining? — 이벤트 로그 데이터에 알고리즘을 적용해 실제 프로세스 흐름의 패턴과 세부를 찾는 프로세스 마이닝의 정의를 확인했습니다.
- Celonis, What is Process Mining? — 프로세스가 실제로 어떻게 운영되는지 보여준다는 설명과 재무·공급망·공유서비스 적용 영역을 참고했습니다.
- IBM, What Are AI Agents? — 가용한 도구로 워크플로를 설계하며 자율적으로 업무를 수행하는 AI 에이전트의 정의를 확인했습니다.
- NIST, AI Risk Management Framework — AI RMF 공식 개요와 RMF 1.0 개정 진행 상황을 확인했습니다.
- NIST AI 100-1, AI Risk Management Framework 1.0 PDF — GOVERN·MAP·MEASURE·MANAGE 네 기능 구조를 확인했습니다.