LLM 모델 양자화란 무엇인가
FP16·BF16 LLM을 INT8·INT4·FP8·NF4로 양자화할 때 무엇이 달라지는지, PTQ·QAT·GPTQ·AWQ·GGUF·bitsandbytes·QLoRA의 차이와 실무 선택 기준을 정리합니다.
LLM 양자화는 모델을 “작게 만드는 기술”이지만, 단순 압축이 아니라 정확도·속도·메모리·하드웨어 지원 사이의 교환입니다.
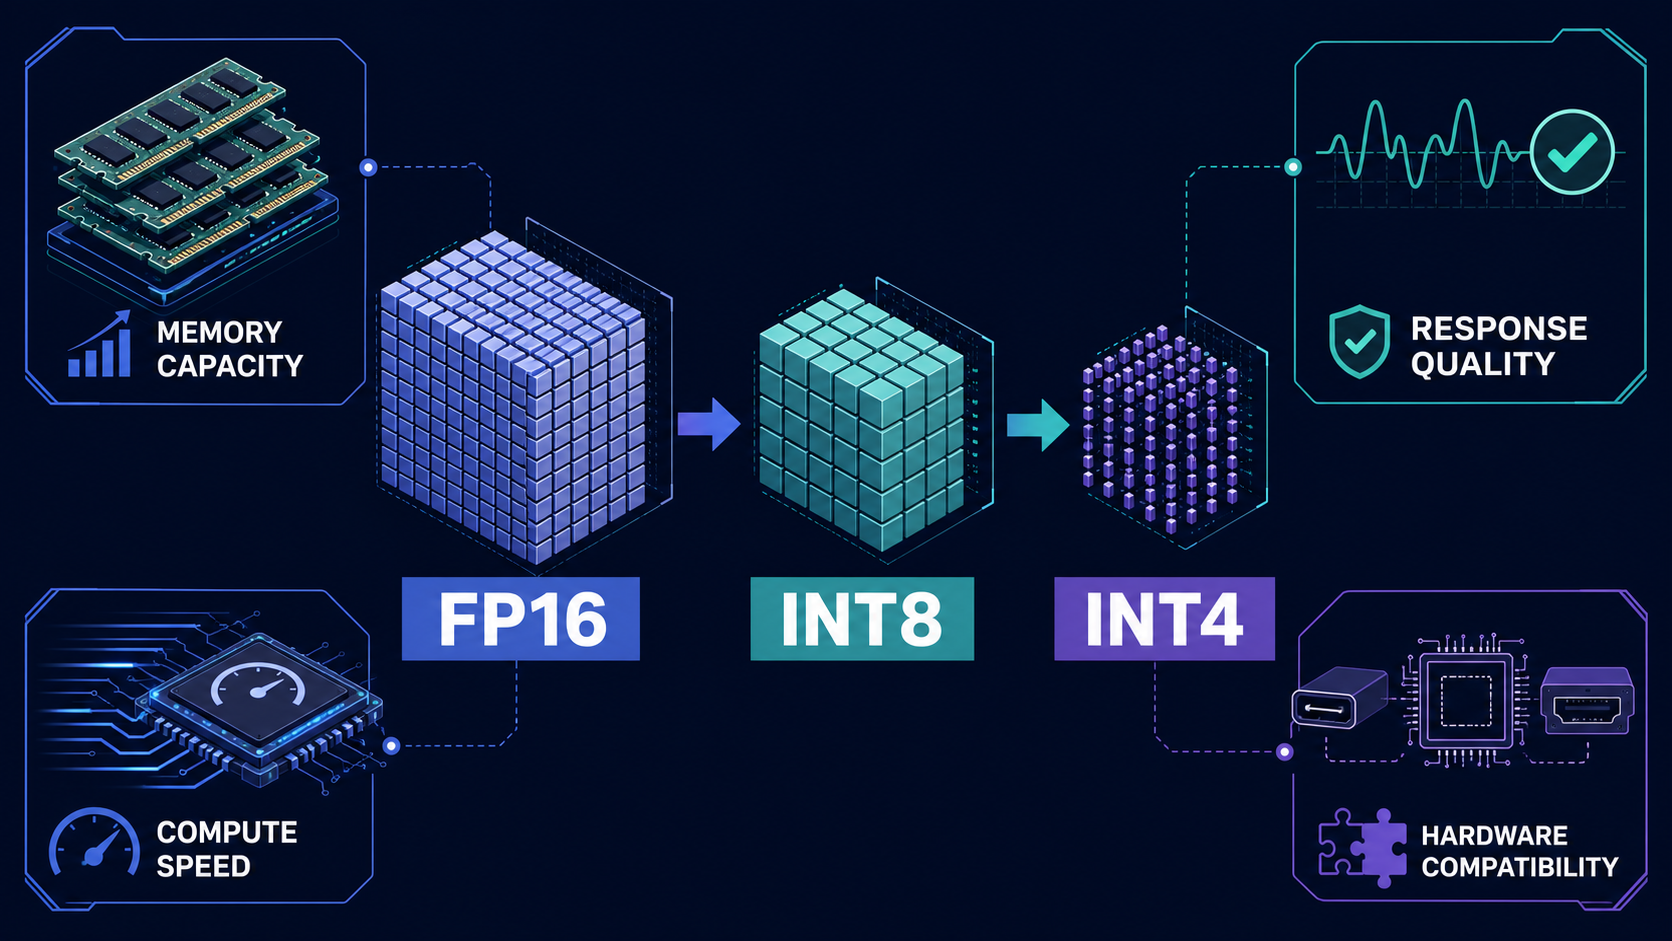
INT8, INT4, FP8, GPTQ, AWQ, GGUF, bitsandbytes, QLoRA. LLM 양자화를 검색하면 이 이름들이 한꺼번에 쏟아집니다. 그런데 이 이름들은 서로 같은 층위의 말이 아닙니다. 어떤 것은 숫자 형식이고, 어떤 것은 알고리즘이며, 어떤 것은 파일 포맷·런타임 생태계입니다. 그래서 “어떤 양자화가 좋은가”보다 먼저 물어야 할 질문이 있습니다. 이 이름들은 각각 무엇을 줄이는 말이고, 내 장비와 업무에서는 무엇이 실제로 달라지는가? 이 글은 그 질문을 따라 양자화를 네 개의 축(무엇을 줄이는가, 언제 적용하는가, 어떤 이름으로 불리는가, 어디에 쓰는가)으로 나눠 봅니다.
LLM을 로컬 PC나 사내 서버에서 돌려 보려는 순간 가장 먼저 부딪히는 벽은 모델 크기입니다. 70B 모델을 그대로 FP16으로 올리면 가중치만 대략 140GB 수준의 메모리를 요구합니다. 실제 추론에는 여기에 KV 캐시, 런타임 오버헤드, 배치 처리 공간까지 더 필요합니다. 그래서 “모델은 공개되어 있는데 내 장비에는 안 올라가는” 상황이 흔하게 생깁니다.
참고: 본문 뒤에서 다시 보듯 7B 모델은 FP16 기준 가중치만 약 14GB, 70B는 약 140GB입니다. 이 숫자를 장비에 대입하면 체감이 생깁니다. 가중치 140GB는 단일 GPU 한 장의 메모리로는 한참 모자라고, 여러 장을 묶어야 비로소 올라가는 규모입니다. 반대로 7B를 INT4로 줄이면 이론상 약 3.5GB 수준까지 내려와 개인 노트북에서도 실험이 가능해집니다. “같은 모델인데 내 장비에 올라가느냐 마느냐”가 바로 이 숫자 차이에서 갈립니다. (수치는 가중치 기준 이론값이며, 실제 메모리는 스케일·메타데이터·KV 캐시·런타임 오버헤드로 달라집니다.)
이때 등장하는 핵심 기술이 양자화(quantization)입니다. 양자화는 모델의 가중치나 활성값을 더 낮은 정밀도의 숫자로 표현해 메모리 사용량과 연산 비용을 줄이는 방법입니다. 예를 들어 FP16으로 저장하던 가중치를 INT8이나 INT4로 바꾸면 같은 모델을 훨씬 작은 메모리에 담을 수 있습니다.
다만 양자화를 “파일 크기를 줄이는 압축”으로만 이해하면 곤란합니다. LLM 양자화의 본질은 숫자 표현을 바꾸는 것입니다. 숫자 표현이 바뀌면 모델이 계산하는 방식도 바뀌고, 그 결과 정확도·속도·지원 하드웨어·서빙 프레임워크가 함께 영향을 받습니다.
이 글의 한 줄 결론은 이렇습니다. LLM 양자화는 로컬 실행과 추론 비용 절감을 가능하게 하지만, 어떤 양자화를 쓰느냐에 따라 품질 손실과 운영 조건이 완전히 달라진다.
양자화는 무엇을 바꾸는가
딥러닝 모델은 수많은 숫자, 즉 파라미터로 구성됩니다. 이 숫자는 보통 학습과 추론에서 FP32, FP16, BF16 같은 부동소수점 형식으로 표현됩니다. FP32는 정밀하지만 무겁고, FP16·BF16은 더 가볍지만 여전히 대형 LLM에는 큰 메모리를 요구합니다.
양자화는 이 숫자를 더 적은 비트 수로 표현합니다.
| 표현 방식 | 대략적 의미 | 주 사용처 |
|---|---|---|
| FP32 | 32비트 부동소수점 | 학습, 기준 정확도 평가 |
| FP16 / BF16 | 16비트 부동소수점 | GPU 추론·학습의 기본값 |
| FP8 | 8비트 부동소수점 | 최신 GPU 추론·학습 가속 (데이터센터 가속기) |
| INT8 | 8비트 정수 | 추론 최적화, 비교적 안정적인 압축 |
| INT4 | 4비트 정수 | 로컬 LLM, 대형 모델 메모리 절감 |
| NF4 | 4비트 정규분포 기반 표현 | QLoRA 같은 4비트 파인튜닝 |
예를 들어 7B 모델의 가중치를 FP16으로 저장하면 가중치만 약 14GB가 필요합니다. INT8이면 이론적으로 절반, INT4이면 4분의 1 수준까지 줄일 수 있습니다. 물론 실제 파일 크기와 메모리 사용량은 스케일 값, 메타데이터, 그룹 크기, 런타임 오버헤드 때문에 정확히 이론값과 같지는 않습니다.
핵심은 “낮은 비트 = 무조건 좋음”이 아니라는 점입니다. 비트 수가 낮아질수록 메모리는 줄지만, 모델이 표현할 수 있는 숫자 범위와 세밀함도 줄어듭니다. 그래서 양자화는 항상 다음 질문과 함께 봐야 합니다.
- 품질 손실을 어느 정도까지 허용할 수 있는가?
- CPU에서 돌릴 것인가, GPU에서 돌릴 것인가?
- 목표가 파일 크기 절감인가, 실제 추론 속도 향상인가?
- 채팅 한두 명용인가, 동시 요청이 많은 서비스용인가?
- 파인튜닝까지 할 것인가, 추론만 할 것인가?
양자화의 첫 번째 구분: 가중치만 줄일 것인가, 계산 전체를 줄일 것인가
LLM 양자화를 이해할 때 가장 중요한 구분은 무엇을 양자화하느냐입니다.
첫째, 가중치 양자화(weight quantization)입니다. 모델의 파라미터를 INT8, INT4 같은 낮은 정밀도로 저장합니다. 로컬 LLM에서 가장 흔히 보는 방식입니다. GPTQ, AWQ, GGUF의 여러 Q4·Q5·Q8 포맷, bitsandbytes 8bit/4bit 로딩이 여기에 가깝습니다. 장점은 모델을 훨씬 작은 메모리에 올릴 수 있다는 것입니다. 단점은 실제 계산 과정에서 일부 값이 다시 높은 정밀도로 풀리거나, 특정 커널 지원이 필요해 속도 이득이 환경마다 달라진다는 점입니다.
둘째, 활성값 양자화(activation quantization)입니다. 모델이 입력을 처리하면서 중간에 만들어 내는 활성값까지 낮은 정밀도로 다룹니다. 가중치만 줄이는 것보다 더 적극적인 최적화입니다. 하지만 활성값은 입력에 따라 크게 달라지기 때문에 단순히 줄이면 정확도가 흔들릴 수 있습니다. SmoothQuant 같은 연구는 활성값 양자화가 어려운 이유를 완화하기 위해 가중치와 활성값 사이의 스케일을 조정하는 접근을 제안했습니다.
셋째, KV 캐시 양자화(KV cache quantization)입니다. 긴 대화를 하거나 긴 문서를 넣으면 LLM은 이전 토큰의 key/value 정보를 캐시에 저장합니다. 컨텍스트가 길어질수록 KV 캐시가 메모리를 크게 잡아먹습니다. 그래서 모델 가중치만 줄였는데도 긴 컨텍스트에서 메모리가 터지는 일이 생깁니다. 긴 문서 요약, 코드베이스 분석, 에이전트 워크플로처럼 컨텍스트가 길어지는 업무에서는 KV 캐시 양자화가 중요해집니다.
넷째, 전체 연산 경로의 저정밀도화입니다. 최신 GPU에서는 FP8처럼 하드웨어가 직접 지원하는 낮은 정밀도 연산을 활용해 추론과 학습을 가속합니다. 이 경우는 단순한 모델 파일 변환이 아니라 하드웨어, 프레임워크, 커널, 배치 전략이 함께 맞아야 합니다.
참고: 이 네 구분은 “파일 하나만 바꾸면 끝”이냐 “서빙 스택 전체를 다시 맞춰야 하냐”의 차이를 만듭니다. 가중치 양자화는 모델 파일 교체로 끝나는 경우가 많지만, 활성값·KV 캐시·FP8 연산 경로는 런타임과 하드웨어 지원이 함께 맞아야 효과가 납니다. 그래서 같은 “8비트”라는 말이라도, 가중치만 8비트인지 연산 경로 전체가 8비트인지에 따라 도입 난이도가 완전히 달라집니다.
두 번째 구분: 학습 후 양자화와 양자화 인식 학습
양자화는 언제 적용하느냐에 따라서도 나뉩니다.
1. PTQ: 학습 후 양자화
PTQ(Post-Training Quantization)는 이미 학습된 모델을 가져와 나중에 양자화하는 방식입니다. 사용자는 원본 모델을 다시 학습하지 않고, 캘리브레이션 데이터나 알고리즘을 이용해 가중치를 낮은 정밀도로 바꿉니다.
실무에서 가장 많이 접하는 LLM 양자화가 PTQ입니다. GPTQ, AWQ, GGUF 변환 모델 대부분이 이 범주에 들어갑니다. 장점은 빠르고 비용이 적다는 것입니다. 이미 공개된 모델을 내려받아 양자화 버전을 쓰거나 직접 변환할 수 있습니다.
단점은 모델이 처음부터 낮은 정밀도를 전제로 학습된 것이 아니기 때문에 품질 손실이 생길 수 있다는 점입니다. 특히 2비트·3비트처럼 극단적으로 낮은 비트에서는 언어 품질, 수학·코딩 성능, 긴 컨텍스트 안정성이 흔들릴 가능성이 커집니다.
2. QAT: 양자화 인식 학습
QAT(Quantization-Aware Training)는 학습 또는 추가 학습 과정에서 양자화 오차를 모델이 미리 겪도록 하는 방식입니다. 모델이 낮은 정밀도 환경에 적응할 기회를 갖기 때문에 PTQ보다 품질을 더 잘 유지할 수 있습니다.
하지만 비용이 큽니다. LLM 규모에서는 다시 학습하거나 추가 학습하는 비용이 만만치 않습니다. 그래서 일반 사용자나 작은 팀은 QAT보다 PTQ 계열을 더 자주 사용합니다. QAT는 모델 제작자, 대형 서비스 사업자, 특정 하드웨어 배포를 목표로 하는 팀에게 더 현실적인 선택지입니다.
3. QLoRA: 양자화 모델 위에 어댑터를 학습하는 방식
QLoRA는 조금 다른 위치에 있습니다. 원본 대형 모델을 4비트로 양자화해 메모리에 올리고, 그 위에 LoRA 어댑터를 학습합니다. 즉 “양자화된 모델을 그대로 서비스한다”기보다는, 제한된 GPU 메모리에서 대형 모델을 파인튜닝하기 위한 방법입니다.
QLoRA 논문은 4비트 NormalFloat(NF4), double quantization, paged optimizer 같은 기법을 조합해 대형 모델 파인튜닝의 메모리 부담을 낮추는 접근을 제시했습니다. 그래서 QLoRA는 “로컬 추론용 GGUF Q4”와 같은 말이 아닙니다. 둘 다 4비트라는 숫자는 같지만 목표와 사용 맥락이 다릅니다.
참고: 한 줄로 정리하면 이렇습니다. GGUF Q4는 “줄인 모델을 그대로 돌리기 위한” 포맷이고, QLoRA의 NF4는 “줄인 모델 위에서 어댑터를 학습하기 위한” 표현입니다. 둘 다 화면에는 4비트로 보이지만, 하나는 추론의 끝이고 다른 하나는 학습의 시작입니다.
세 번째 구분: 대표적인 LLM 양자화 방식들
LLM을 실제로 쓰다 보면 “INT8”, “GPTQ”, “AWQ”, “GGUF”, “NF4” 같은 이름이 섞여 나옵니다. 이 이름들은 서로 같은 층위의 분류가 아닙니다. 어떤 것은 숫자 형식이고, 어떤 것은 알고리즘이며, 어떤 것은 파일 포맷·런타임 생태계에 가깝습니다.
이름들이 섞여 보인다면, 먼저 “이 이름이 가리키는 층위”로 나눠 보면 정리가 쉽습니다.
| 이름 | 층위 | 한 줄 성격 |
|---|---|---|
| INT8 / INT4 / FP8 / NF4 | 숫자 형식 | 몇 비트, 어떤 방식으로 숫자를 표현하는가 |
| GPTQ / AWQ | 양자화 알고리즘 | 낮은 비트로 줄이는 절차·기법 (PTQ 계열) |
| bitsandbytes | 라이브러리·생태계 | HF 생태계에서 8bit/4bit 로딩·QLoRA를 쉽게 |
| GGUF | 파일 포맷·런타임 생태계 | llama.cpp 계열 로컬 실행을 위한 저장 형식 |
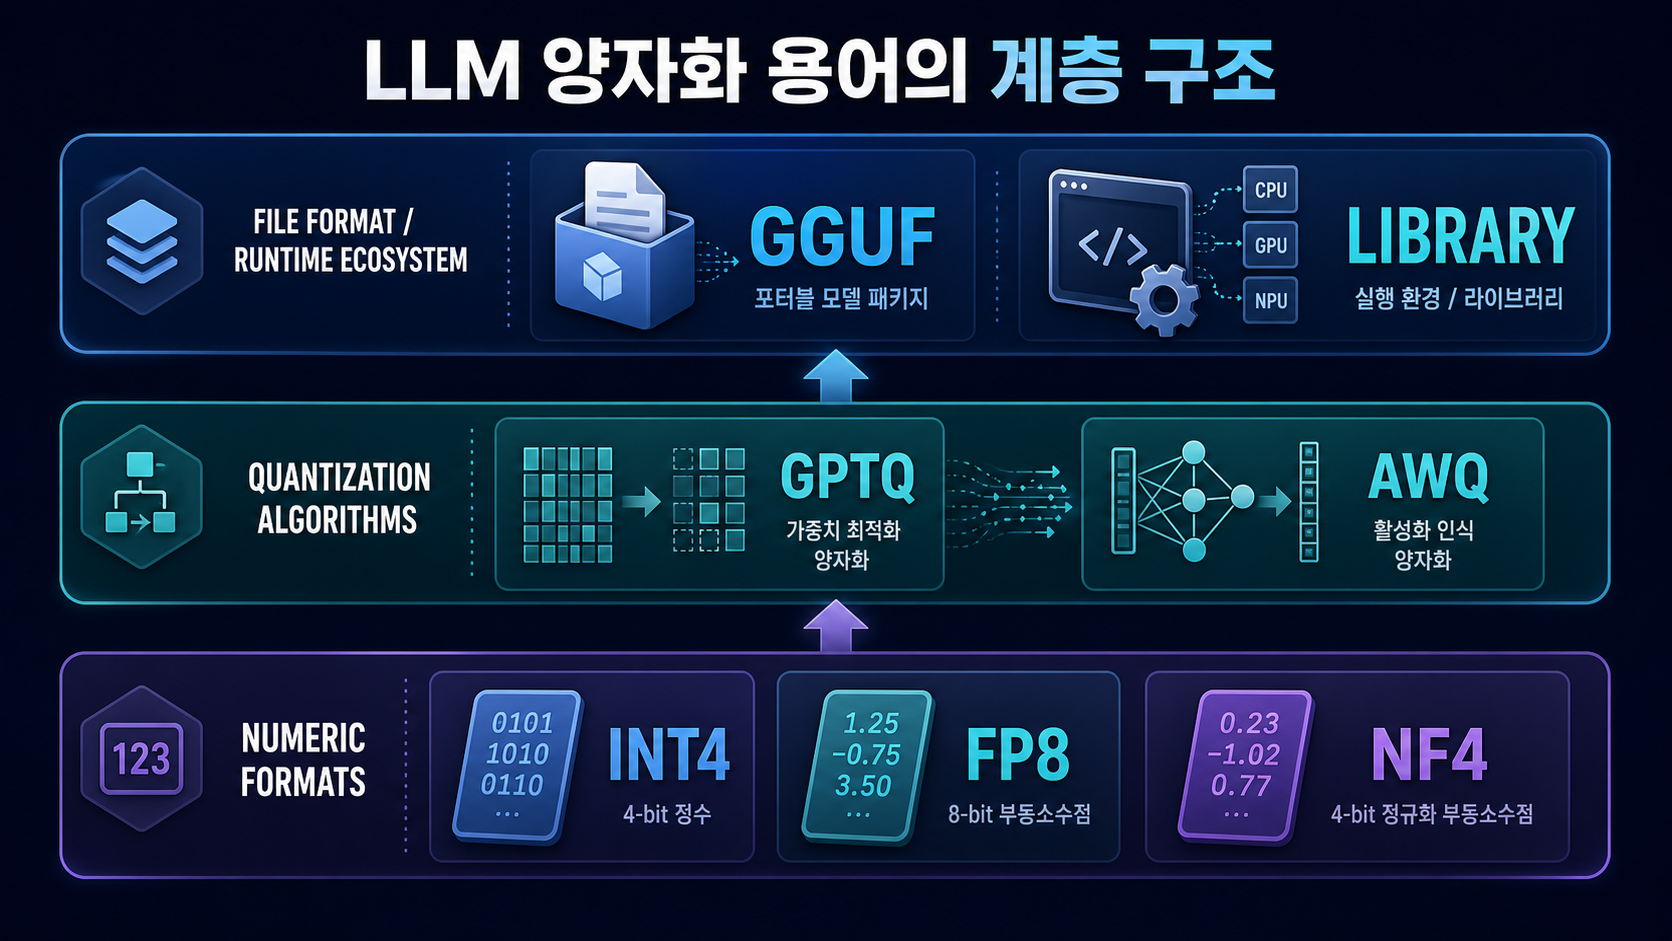
즉 “INT4”는 숫자 형식이고, “GPTQ”는 그 INT4를 만드는 방법 중 하나이며, “GGUF Q4_K_M”은 그렇게 줄인 결과를 담아 로컬에서 돌리는 포맷입니다. 같은 4비트를 가리키면서도 말이 다른 이유가 여기 있습니다.
1. INT8 양자화: 가장 보수적인 출발점
INT8은 8비트 정수 표현입니다. FP16 대비 메모리 사용량을 줄이면서도 품질 손실이 비교적 작아 실무에서 오래 쓰였습니다. GPU와 CPU 가속 라이브러리 지원도 넓은 편입니다.
LLM에서는 8비트 가중치 로딩이 “성능을 크게 망치지 않으면서 메모리 절약을 얻는” 출발점으로 자주 쓰입니다. bitsandbytes의 8-bit 기능이 대표적입니다. 다만 8비트는 4비트보다 메모리 절감 폭이 작습니다. 로컬 PC에서 더 큰 모델을 억지로 올려야 하는 상황에서는 4비트가 더 매력적으로 보입니다.
2. INT4 / 4비트 양자화: 로컬 LLM의 대중화 기술
4비트 양자화는 로컬 LLM 생태계에서 매우 중요합니다. 같은 GPU 메모리로 더 큰 모델을 올릴 수 있기 때문입니다. 7B, 13B, 34B, 70B 모델을 개인 장비나 작은 서버에서 실험할 수 있게 만든 핵심 배경 중 하나가 4비트 양자화입니다.
하지만 4비트는 품질과 속도의 균형이 더 민감합니다. 어떤 모델은 Q4에서도 충분히 자연스럽지만, 어떤 모델은 지식 회상·수학·코딩·긴 문맥에서 품질 저하가 체감될 수 있습니다. 또한 4비트 파일이라고 해서 항상 빠른 것도 아닙니다. CPU에서 메모리 대역폭 병목을 줄여 빨라질 수 있지만, GPU에서는 커널 지원과 dequantization 비용에 따라 결과가 달라집니다.
3. GPTQ: 한 번에 쓰기 쉬운 PTQ 계열
GPTQ는 대형 Transformer 모델을 위한 학습 후 양자화 방식입니다. 원본 모델을 다시 학습하지 않고도 비교적 높은 정확도를 유지하면서 가중치를 낮은 비트로 줄이는 데 초점을 둡니다.
GPTQ의 장점은 이미 많은 공개 모델과 도구 생태계에서 지원된다는 점입니다. Hugging Face Transformers에도 GPTQ 관련 문서가 있고, 여러 커뮤니티 모델이 GPTQ 형식으로 배포됩니다. 단점은 캘리브레이션 데이터와 설정에 따라 품질이 달라질 수 있고, 모든 하드웨어·런타임에서 같은 성능을 보장하지 않는다는 점입니다.
4. AWQ: 중요한 가중치를 더 조심스럽게 다루는 방식
AWQ(Activation-aware Weight Quantization)는 모든 가중치를 똑같이 다루지 않고, 활성값 관점에서 중요한 가중치를 더 보호하는 아이디어를 사용합니다. AWQ 논문은 LLM 가중치 중 일부 중요한 채널을 잘 보존하면 낮은 비트에서도 성능을 유지할 수 있다는 방향을 제시했습니다.
실무적으로 AWQ는 4비트 추론에서 자주 언급됩니다. vLLM 같은 서빙 프레임워크도 AWQ를 지원합니다. 다만 AWQ 역시 만능은 아닙니다. 모델 구조, 하드웨어, 커널, 배치 크기에 따라 속도와 품질 체감이 달라집니다.
5. bitsandbytes 8bit/4bit: 파이썬 생태계의 쉬운 진입로
bitsandbytes는 Hugging Face 생태계에서 8비트·4비트 로딩과 QLoRA 워크플로에 널리 쓰이는 라이브러리입니다. 개발자는 Transformers에서 설정 몇 줄로 모델을 8비트 또는 4비트로 불러올 수 있습니다.
장점은 접근성이 좋다는 것입니다. 로컬 실험, 파인튜닝, PoC에 빠르게 적용할 수 있습니다. 단점은 운영 서빙에서 최적 성능을 내기 위해서는 GPU 종류, CUDA, 커널, 프레임워크 버전 호환성을 확인해야 한다는 점입니다. “노트북에서 로딩 성공”과 “운영 서비스에서 빠르고 안정적으로 응답”은 다른 문제입니다.
6. GGUF: llama.cpp 계열 로컬 실행 포맷
GGUF는 llama.cpp 생태계에서 널리 쓰이는 모델 파일 포맷입니다. Q4_K_M, Q5_K_M, Q8_0 같은 이름으로 다양한 양자화 옵션을 볼 수 있습니다. CPU 중심 로컬 실행, Apple Silicon, 작은 GPU 오프로딩 등 개인·엣지 환경에서 자주 사용됩니다.
GGUF를 이해할 때 중요한 점은 이것이 단순히 “4비트 알고리즘 하나”가 아니라는 것입니다. GGUF는 파일 포맷과 런타임 생태계의 성격이 강합니다. 같은 4비트라도 Q4_0, Q4_K_M처럼 세부 방식이 다르고, 품질·속도·파일 크기가 다르게 나타납니다.
7. FP8: 최신 가속기 시대의 저정밀도
FP8은 정수 양자화와는 다르게 8비트 부동소수점 형식입니다. NVIDIA H100 이후 세대, 일부 최신 AI 가속기에서 FP8 연산 지원이 중요해졌습니다. FP8은 대형 모델 추론과 학습에서 메모리·대역폭·연산 효율을 높이는 방향으로 쓰입니다.
다만 개인 로컬 LLM 사용자가 GGUF 파일을 고르는 문제와 FP8 데이터센터 추론 최적화는 맥락이 다릅니다. FP8은 하드웨어와 프레임워크 지원이 맞아야 효과가 납니다. 따라서 “FP8이 좋다”가 아니라 “내가 쓰는 GPU와 서빙 스택이 FP8을 제대로 지원하는가”가 먼저입니다.
같은 4비트라도 왜 결과가 다를까
양자화 모델을 고를 때 가장 헷갈리는 지점은 같은 4비트인데도 모델마다 평가가 다르다는 것입니다. 이유는 간단합니다. 4비트라는 숫자는 최종 결과를 설명하기에 너무 거친 정보입니다.
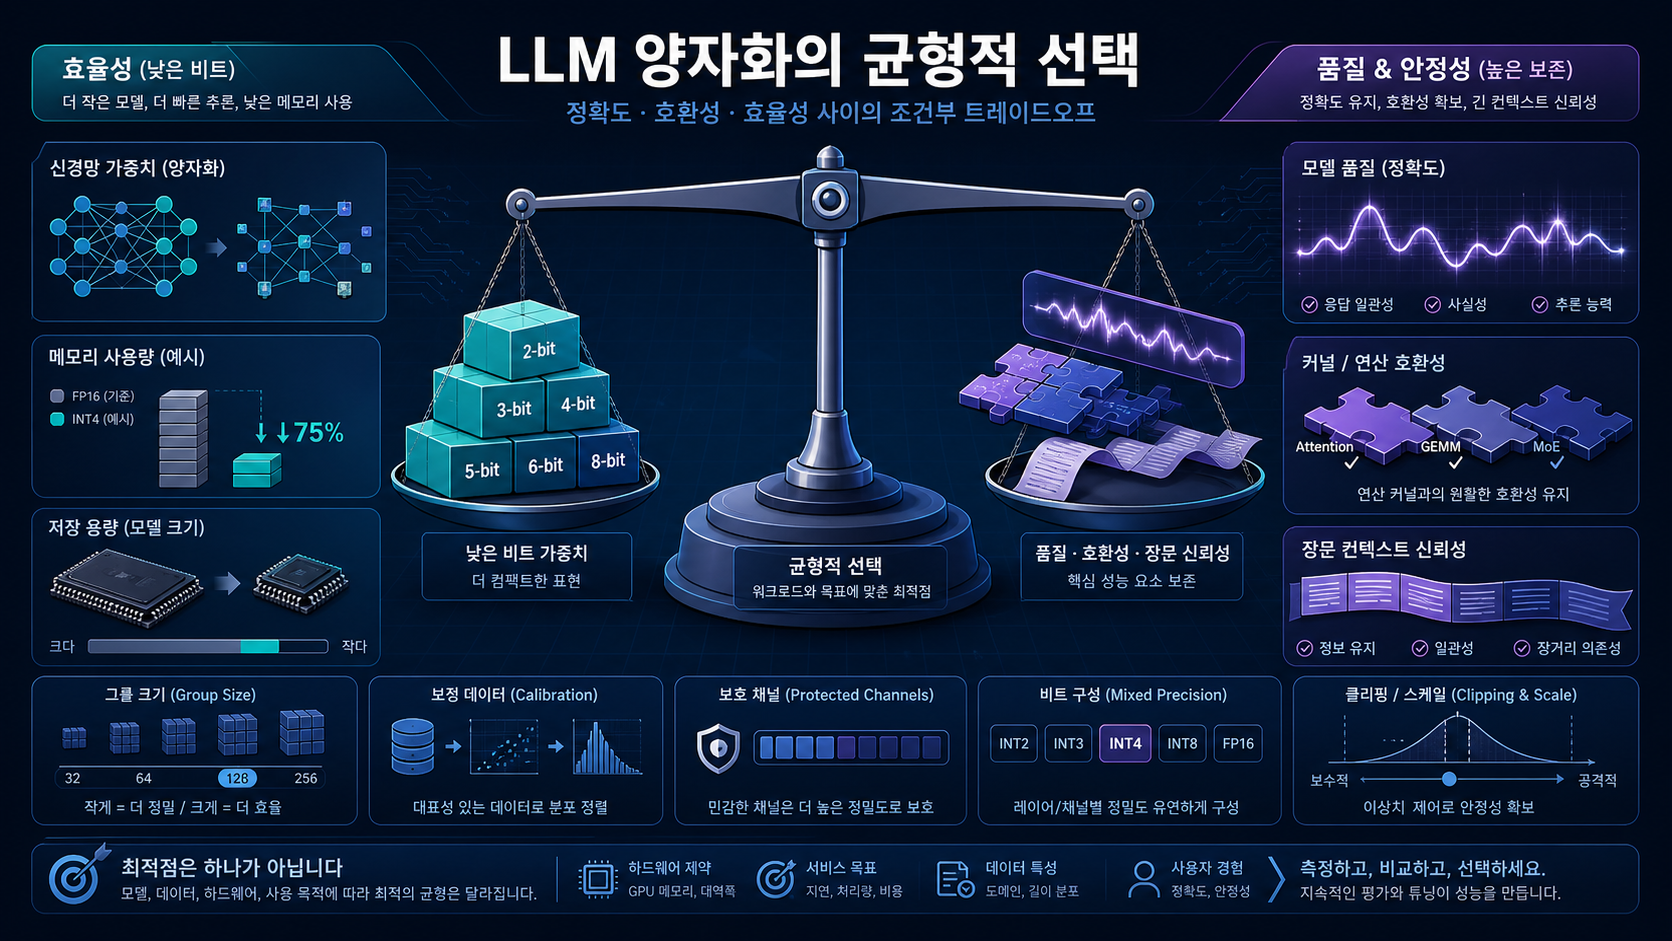
비유로 이해하면 이렇습니다. 사진도 “1200만 화소”라는 숫자가 같아도, 어떤 코덱으로 압축했는지, 어떤 설정으로 줄였는지에 따라 결과물이 완전히 다릅니다. 같은 화소라도 디테일과 색이 사는 사진이 있고, 뭉개지는 사진이 있습니다. 양자화도 마찬가지입니다. “4비트”는 화소 수처럼 거친 라벨일 뿐이고, 실제 품질은 그 라벨 뒤에 숨은 변수들이 결정합니다.
결과를 가르는 변수는 여럿입니다.
- 그룹 크기: 몇 개의 가중치를 한 묶음으로 스케일링할 것인가
- 대칭/비대칭 양자화: 0을 중심으로 대칭 범위를 쓸 것인가, 별도 zero-point를 둘 것인가
- 캘리브레이션 데이터: 어떤 예시 문장으로 양자화 오차를 맞췄는가
- 중요 채널 보호: 일부 민감한 가중치를 더 높은 정밀도로 남겼는가
- 런타임 커널: 실제 하드웨어에서 해당 형식을 빠르게 계산할 수 있는가
- 컨텍스트 길이: 짧은 채팅에서는 괜찮아도 긴 문서에서는 문제가 드러나는가
그래서 양자화 모델은 파일명만 보고 고르면 안 됩니다. “Q4니까 원본과 거의 같다” 또는 “Q8이니까 항상 빠르다”는 식의 단정은 위험합니다. 실제로는 내가 쓰는 업무 프롬프트로 테스트해야 합니다.
양자화의 장점
양자화의 장점은 명확합니다.
첫째, 메모리 사용량이 줄어듭니다. 같은 GPU나 CPU 메모리에서 더 큰 모델을 실행할 수 있습니다. 로컬 LLM에서 가장 직접적인 장점입니다.
둘째, 메모리 대역폭 부담이 줄어듭니다. 추론은 종종 연산량보다 메모리에서 가중치를 읽어 오는 속도에 묶입니다. 가중치가 작아지면 메모리 이동량이 줄어 속도가 빨라질 수 있습니다.
셋째, 비용 선택지가 넓어집니다. 더 작은 GPU, 더 저렴한 클라우드 인스턴스, CPU/엣지 장비에서도 실행 가능성이 생깁니다. API만 쓰던 팀이 내부 PoC를 해볼 수 있고, 대형 모델을 작은 서버에서 검증할 수도 있습니다.
넷째, 파인튜닝 장벽이 낮아집니다. QLoRA처럼 양자화된 기반 모델 위에서 어댑터를 학습하면 제한된 GPU 메모리로도 더 큰 모델을 다룰 수 있습니다.
양자화의 한계
하지만 양자화는 공짜 점심이 아닙니다.
첫째, 품질 손실이 생길 수 있습니다. 일반 대화에서는 차이가 작아 보여도 수학, 코딩, 긴 문서 추론, 도구 호출, 한국어 세부 표현에서 차이가 드러날 수 있습니다.
둘째, 속도가 항상 빨라지는 것은 아닙니다. 파일 크기는 줄었는데 실제 추론은 느릴 수 있습니다. 낮은 비트 가중치를 계산 전에 풀어야 하거나, 해당 GPU에 최적화된 커널이 없거나, CPU와 GPU 사이의 오프로딩 비용이 커질 수 있기 때문입니다.
셋째, 호환성 문제가 생깁니다. GPTQ, AWQ, GGUF, bitsandbytes는 사용하는 프레임워크와 런타임이 다릅니다. 같은 모델이라도 Transformers에서는 잘 되는데 vLLM에서는 제약이 있거나, llama.cpp에서는 잘 되지만 특정 GPU 커널은 못 쓰는 경우가 있습니다.
넷째, 평가가 어려워집니다. 공개 벤치마크 점수가 괜찮아도 내가 쓰는 업무에서는 다르게 나타날 수 있습니다. 특히 사내 문서 요약, 한국어 보고서 작성, 코드베이스 분석처럼 도메인 특성이 있는 업무는 별도 평가가 필요합니다.
실무에서는 어떻게 고르면 좋을까
양자화 방식을 고를 때는 이름보다 목적을 먼저 정해야 합니다.
표를 보기 전에, 먼저 아래 다섯 가지부터 답해 두면 선택이 훨씬 빨라집니다.
지금 당장 확인할 5가지
- 장비: CPU만 있는가, GPU가 있는가? GPU라면 VRAM은 얼마인가?
- 목적: 추론만 할 것인가, 파인튜닝까지 할 것인가?
- 동시성: 혼자 쓰는 채팅인가, 여러 요청을 받는 서비스인가?
- 컨텍스트: 짧은 대화인가, 긴 문서·에이전트 워크플로인가?
- 품질 기준: 일반 대화 수준이면 충분한가, 수학·코딩·한국어 전문 표현이 중요한가?
이 다섯 답을 정하고 나면, 아래 표에서 “내 목적 행”만 골라 보면 됩니다.
| 목적 | 우선 검토할 방식 | 확인할 점 |
|---|---|---|
| 개인 PC에서 로컬 채팅 | GGUF Q4/Q5, llama.cpp 계열 | 응답 품질, 초당 토큰, 메모리 여유 |
| GPU 한 장으로 큰 모델 실험 | bitsandbytes 4bit, GPTQ, AWQ | CUDA 호환성, VRAM, 커널 지원 |
| 서비스형 GPU 추론 | AWQ, GPTQ, FP8, vLLM 지원 포맷 | 동시성, 배치 성능, 지연시간, 장애 대응 |
| 긴 문서·에이전트 | 가중치 양자화 + KV 캐시 최적화 | 긴 컨텍스트 품질, 캐시 메모리, 반복 입력 |
| 파인튜닝 | QLoRA, NF4 | 학습 안정성, 어댑터 품질, 데이터 품질 |
| 정확도가 최우선 | FP16/BF16 또는 INT8 | 기준 모델 대비 손실, 업무별 평가 |
제가 실제로 본 두 경우입니다. 같은 13B 모델을 두고 서로 다른 결론에 이르렀습니다. 저는 개인 노트북에서 한국어 상담 초안을 잡아 보는 것이 목표였습니다. 이 경우에는 GPU VRAM보다 “일단 올라가고, 응답이 자연스러운가”가 중요했습니다. 그래서 GGUF Q4_K_M을 llama.cpp로 돌려 보고, 실제 상담 프롬프트 몇 건으로 체감 품질을 확인했습니다. 반면 사내 메신저에 붙여 여러 직원이 동시에 쓰는 봇을 만들던 팀은 달랐습니다. 이 팀에게는 첫 토큰 지연시간과 동시성이 중요했습니다. 그래서 GPU 서버에서 vLLM이 지원하는 AWQ 또는 GPTQ 포맷을 고르고, 배치 처리와 장애 재시작까지 점검했습니다. 두 경우가 고른 “4비트”는 같은 숫자지만, 도달한 파일과 운영 조건은 완전히 다릅니다. 차이는 모델이 아니라 목적과 장비에서 왔습니다.
초보자라면 보통 다음 순서가 현실적입니다.
- 원본 FP16/BF16 모델의 기준 품질을 먼저 확인합니다.
- 로컬 실행이 목적이면 GGUF Q4_K_M 또는 Q5_K_M 같은 보편적 선택지로 시작합니다.
- GPU 서버에서 추론할 목적이면 vLLM이 지원하는 GPTQ·AWQ·FP8 조합을 확인합니다.
- 파인튜닝이 목적이면 bitsandbytes 4bit와 QLoRA 워크플로를 검토합니다.
- 최종 선택 전에는 반드시 내 업무 데이터로 평가합니다.
평가할 때는 무엇을 봐야 할까
양자화 모델을 평가할 때 단순히 “대답이 자연스러운가”만 보면 부족합니다. 최소한 다음 항목을 확인해야 합니다.
- 정확도: 원본 모델 대비 사실 오류가 늘어나는가
- 추론 안정성: 긴 지시문에서 중간 조건을 잊지 않는가
- 한국어 품질: 조사, 어미, 전문용어 번역이 흔들리지 않는가
- 코딩 품질: 작은 문법 오류나 API 오용이 늘지 않는가
- 긴 컨텍스트: 긴 문서 후반부 정보를 유지하는가
- 속도: 첫 토큰 지연시간과 초당 토큰이 실제로 개선되는가
- 메모리: 가중치뿐 아니라 KV 캐시까지 포함해 여유가 있는가
- 운영성: 재시작, 배치, 모니터링, 버전 고정이 가능한가
특히 업무용 LLM에서는 “벤치마크 1점 차이”보다 “내가 매일 쓰는 입력에서 실패하지 않는가”가 더 중요합니다. 양자화 모델은 배포 전에 작은 회귀 테스트 세트를 만들어 비교하는 것이 안전합니다.
결론: 양자화는 작은 모델을 만드는 기술이 아니라 선택지를 넓히는 기술이다
LLM 양자화는 모델을 작게 만들고, 더 저렴한 장비에서 실행하게 해주며, 대형 모델의 실험 장벽을 낮춥니다. 그래서 로컬 LLM, 사내 PoC, GPU 비용 최적화, QLoRA 파인튜닝에서 핵심 기술이 되었습니다.
하지만 양자화는 마법이 아닙니다. 낮은 비트로 갈수록 품질 손실 가능성이 커지고, 속도 이득은 하드웨어와 커널 지원에 따라 달라집니다. GPTQ, AWQ, GGUF, bitsandbytes, FP8, NF4는 서로 같은 종류의 이름이 아니며, 각각 알고리즘·포맷·런타임·숫자 표현의 층위가 다릅니다.
따라서 좋은 질문은 “어떤 양자화가 제일 좋은가”가 아닙니다. 더 정확한 질문은 이것입니다.
내가 쓰려는 모델, 장비, 프레임워크, 업무 품질 기준에서 어떤 양자화가 가장 적은 손실로 충분한 성능을 내는가?
이 질문에 답할 때 양자화는 단순한 압축 기술이 아니라, LLM을 실제 업무 환경에 맞게 배치하는 설계 도구가 됩니다.
그리고 이 질문은 한 번 답하고 끝나는 문제가 아닙니다. 모델은 계속 새 버전이 나오고, 하드웨어와 서빙 프레임워크도 바뀝니다. 그래서 양자화 선택은 “정답을 고르는 일”보다 “내 업무 데이터로 다시 검증하는 습관”에 가깝습니다. 오늘 고른 Q4가 다음 분기에도 그대로 유효하리라는 보장은 없습니다. 결국 남는 질문은 이것입니다. 우리 팀은 양자화 모델을 바꿀 때마다 무엇을 기준으로 다시 검증할 것인가?
이 글은 공개 보도와 공식 자료를 바탕으로 한 기술 해설입니다. 특정 기업이나 증권에 대한 매수·매도 권유가 아니며, 투자 판단의 근거로 사용할 수 없습니다.